論壇、聊天室、評論區這類場景,敏感詞過濾是標配。如果關鍵詞只有幾個,反覆調 indexOf 或正則還勉強能用;一旦關鍵詞上升到成百上千,把全文拿來匹配幾百遍,性能開銷完全不可接受。而待檢測的文本通常體量不小,所以目標很明確:全文只遍歷一次,一次拿到所有命中結果。
思路:把關鍵詞組織成一棵樹
遍歷全文的話,自然的想法是逐字符走:遇到某個字符,看它後面能不能接上可能的下一個字符,能一路走到底就算命中,否則換下一個起點。
舉個例子,文本是:
Mike Jordan had said "Just do IT", so Mark has been a coder.
關鍵詞是 Mike 和 Mark。遍歷到 M 時,往後看是 i 還是 a;如果是 i,再往後看是不是 k……一直走到末尾則匹配成功。
那麼關鍵詞集合就應該組織成這樣的前綴樹結構:
var keywords = {
  M: {
    i: { k: { e: { end: true } } },
    a: { r: { k: { end: true } } }
  }
}
這是一個典型的樹(更準確地說是 Trie,前綴樹)。遍歷全文時,每個字符只需沿樹往下走一步或停止,不必回頭重掃。
構建這棵樹需要時間,但關鍵詞是我們預先確定的,所以完全可以提前建好複用。
建樹
function buildTree(keywords) {
  var tblCur = {}, key, str_key, Length, j, i;
  var tblRoot = tblCur;

  for (j = keywords.length - 1; j >= 0; j -= 1) {
    str_key = keywords[j];
    Length = str_key.length;
    for (i = 0; i < Length; i += 1) {
      key = str_key.charAt(i);
      if (tblCur.hasOwnProperty(key)) {
        tblCur = tblCur[key];
      } else {
        tblCur = tblCur[key] = {};
      }
    }
    tblCur.end = true; // 標記這是一個關鍵詞的結尾
    tblCur = tblRoot;  // 回到根節點處理下一個詞
  }
  return tblRoot;
}
這裡有個容易看暈的連等語句 tblCur = tblCur[key] = {}。要注意求值順序:下標運算的優先級高於賦值,所以先在 tblCur 上創建 key 屬性,再把新對象賦上去,最後 tblCur 指向新對象。結合 tblRoot = tblCur = {} 展開看:
var tblRoot = tblCur = {};
tblRoot = tblCur;
tblCur['key'] = undefined; // now tblRoot = {key: undefined}
tblCur['key'] = {};
tblCur = tblCur['key'];
匹配
對目標字符串的每個字符,都從樹根重新開始往下走:先看 keywords[a],存在則看 keywords[a][b],若最終走到某個節點的 end 為 true 即命中;中途走不通則從下一個位置重新起算。
function search(content) {
  var tblCur, p_star = 0, n = content.length, p_end, match,
      match_key, match_str, arrMatch = [], arrLength = 0;

  while (p_star < n) {
    tblCur = tblRoot;   // 回溯至根部
    p_end = p_star;
    match_str = "";
    match = false;

    do {
      match_key = content.charAt(p_end);
      if (!(tblCur = tblCur[match_key])) {
        p_star += 1;    // 本次匹配失敗,起點右移一位
        break;
      } else {
        match_str += match_key;
      }
      p_end += 1;
      if (tblCur.end) { // 到達某個關鍵詞的尾部
        match = true;
      }
    } while (true);

    if (match) {
      arrMatch[arrLength] = { key: match_str, begin: p_star - 1, end: p_end };
      arrLength += 1;
      p_star = p_end;   // 命中後直接跳到匹配末尾,避免重疊掃描
    }
  }
  return arrMatch;
}
這就是整個匹配系統的核心。我用一篇 50 萬字的《搜神記》做測試,從中查找 300 個給定成語,耗時大約 1 秒。更關鍵的是,由於目標文本只掃一遍,文本長度對耗時的影響幾乎可以忽略;真正影響性能的是關鍵詞數量——每個字符都要沿樹走一次,樹越大單次查找成本越高。
為什麼這樣反而快
你可能會疑惑:每個字符都要在關鍵詞集合裡走一遍,就算有部分前綴共用,也還是要反覆查找,怎麼會快?答案在 JS 對象的底層實現。
先看數據怎麼存
內存中的數據由值和地址兩部分構成。把內存想象成一本字典,正文是值,目錄是地址。

數組的特點是元素按順序連續排列,可以通過下標直接定位,遍歷簡單。代價是增刪困難:刪掉第 6 項,後面所有元素都要前移;刪掉第 1 項,整個數組都要移動。

鏈表解決了增刪
把每個節點拆成「值」和「指向下一個節點的地址」兩部分,串起來就是鏈表。

增刪只要改寫前驅節點的 next 指針,代價極小。但查找任意位置變得很吃力,必須順著指針依次遍歷。

哈希表合併了兩者的優點

數組裡存鏈表的頭指針,就構成了一個二維結構。至於某個 key 該落到哪一格,由哈希算法(正規譯法是散列算法)決定:通過一個函數對 key 求解,按結果安放數據。key 與實際地址之間形成映射,訪問時不再依賴下標或順序遍歷,而是通過散列函數直接定位。
JS 對象正是這樣的結構。定義 obj.name 時,key 被轉為字符串後經哈希得到一個內存位置,值放進去;讀取時引擎自動算出同一個位置,直接跳到那裡,而不必從頭掃描。這也解釋了幾個常見現象:為什麼對象的屬性可以隨意增刪,為什麼 JS 數組能掛屬性,為什麼數組沒有傳統意義上的越界報錯。
數據量大時,哈希表的優勢非常明顯,因為它省掉了大量不必要的比較。所謂性能優化,本質就是讓計算機少算;最好的優化,是不算。
再往下的優化空間
理解了底層實現,回頭看算法就能找到優化點。不過先強調一句:不要盲目追求性能。如果實際場景只是幾千字的文本匹配,現有實現完全夠用,所有額外優化都是徒增複雜度。做優化的目的是加深對算法的理解,而不是為省 1 毫秒折騰。
觀察前面的實現可以發現,我們是「以單字為單位」在樹裡逐層走的。但如果關鍵詞都是成語,最短 4 個字,那單字遍歷就是浪費。改法是先統計關鍵詞的最大、最小長度,以最小長度為步長批量比對,命中後再逐字深入探到最大長度。
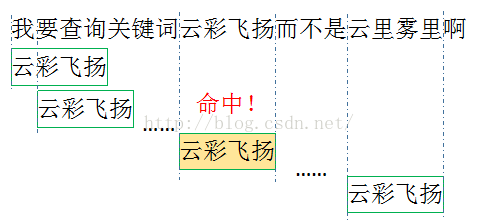
算一下:300 個成語的用例中,一次命中只需一輪比對,而單字查找要進行 4 輪,每輪都要訪問一次樹結構,這部分開銷是可以省掉的。更值得注意的是,這裡的「比對」並不是字符串比較——關鍵詞本身就是作為 key 存在的,效果等同於 key in obj,走的是哈希計算加地址訪問。所以糾結「比一個字還是比四個字」並沒有意義,我們壓根沒做字符串比較。
多關鍵詞匹配的話題就聊到這裡。優化版的代碼就不貼了,日常開發裡一般用不上。
- 上一篇文章: Angular ui-router 頁面跳轉時如何傳遞參數
- 下一篇文章: JavaScript 數字千分位格式化與還原的兩個工具函數