在很长一段时间里,RequireJS 几乎是前端模組化开发的代名词。无论是新接手的老项目,还是从零开始搭建的中后台系统,我都会习惯性地把 RequireJS 放進技術選型清單裡。这篇文章想把它讲清楚:它解决的是什么问题,核心 API 怎么用,以及背后的加载机制到底是如何运作的。
先搞清楚:什么是 JavaScript 模块
模块本质上是一段遵循单一职责原则(SRP)的代码,对外只暴露一份清晰的 API。现代前端开发里,我们习惯把一个功能拆成一个文件、一个模块:表单校验是一个模块,请求封装是一个模块,日期格式化又是一个模块。
拆分本身不难,难的是拆分之后。一旦代码被切成了几十个文件,开发者就必须时刻记住谁依赖谁,并且保证 <script> 的引用顺序绝对正确——被依赖的必须先加载。顺序错一位,运行时立刻报错,而且往往是在用户点击某个按钮时才暴露。
script 标签的三个先天缺陷
传统做法无非下面几种,每一种都有代价:
- 顺序强耦合:必须手工维护依赖顺序,项目越大越容易出错。
- 加载是同步的:浏览器遇到脚本就阻塞解析。加上
async或defer可以异步化,但async又会打乱执行顺序,等于把问题换了个形式。 - 打包也救不了:把所有脚本合并成一个文件确实能减少请求,但合并工具依然需要知道正确的拼接顺序。
换句话说,问题的根源不是"文件太多",而是"依赖关系只存在于开发者的脑子里"。
AMD:让依赖声明变成代码的一部分
AMD(Asynchronous Module Definition,异步模块定义)给出的思路很直接:让模块自己在代码里声明依赖,由加载器负责解析顺序并异步取回。模块和它的依赖可以被并行下载,但执行顺序依然被严格保证。
AMD 属于 CommonJS 规范体系的一部分。同一时期,Node.js 生态选择了另一条路线——同步的 require(),也就是后来广为人知的 CommonJS 模块规范。而在更晚的 ECMAScript 2015 里,import / export 终于被写进了语言本身,成为今天的主流方案。
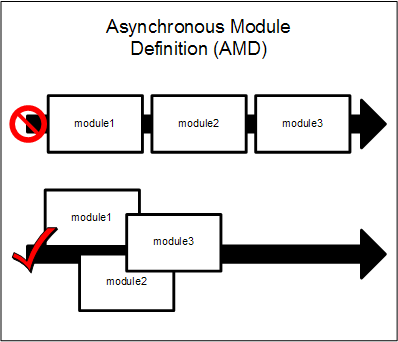
RequireJS 做了什么
RequireJS 是一个 JavaScript 文件与模块加载框架,可以从官网下载,使用 Visual Studio 的话也能通过 NuGet 获取。它同时支持浏览器与 Node.js 一类的服务端环境。
它的工作流程可以概括成三步:
- 你用一个"根入口"告诉它需要哪些功能;
- 它通过
head.appendChild()动态插入<script>去加载依赖; - 所有依赖就绪后,它按正确的依赖拓扑顺序依次调用模块定义函数。
需要强调的是:只有遵循 RequireJS API 编写的模块才能被正确解析。混进一个直接操作全局变量的老式脚本,整套机制就会失效——这也是 shim 存在的原因。
三个核心 API
RequireJS 加载后会创建 requirejs 命名空间,但真正日常使用的三个函数都是全局的:
define:创建模块。每个模块拥有一个唯一 ID。require:读取依赖,但不创建模块。config:配置 RequireJS 自身的行为。
data-main:一切的起点
RequireJS 被加载后,会去找 data-main 属性指向的脚本,把它当作整个应用的入口,并以该脚本所在位置作为默认根路径去加载其余模块。
<script src="scripts/require.js" data-main="scripts/app.js"</script>
另一种设定根路径的方式是配置函数,下面就会讲到。另外要注意:RequireJS 默认所有依赖都是脚本文件,所以书写模块 ID 时不需要加 .js 后缀。
config:把默认行为改成你的样子
调用 require.config() 并传入一个配置对象,就能覆盖默认行为。常用的几项如下:
baseUrl:加载模块的根路径。paths:把某些模块 ID 映射到根路径之外的位置。shim:为那些没有遵循 AMD 规范的老库补充依赖声明与导出配置。deps:声明需要预先加载的依赖数组。
典型写法:
require.config({
  // 默认从 scripts/app 加载所有模块
  baseUrl: 'scripts/app',
  // 例外:以 lib 开头的模块 ID 从 ../lib 加载
  paths: {
    lib: '../lib'
  },
  // Backbone 没有使用 AMD 定义,用 shim 适配
  shim: {
    'backbone': {
      // underscore 必须先于 backbone 加载
      deps: ['underscore'],
      // 用全局变量 Backbone 作为该模块的值
      exports: 'Backbone'
    }
  }
});
这段配置的含义是:根路径为 scripts/app,所有以 lib 开头的模块实际去 scripts/lib 目录下寻找,而 Backbone 通过 shim 方式接入,并自动保证 underscore 先加载。
用 define 定义模块
模块做的是三件事:封装内部实现、暴露接口、限定作用范围。约定上,一个文件只定义一个模块。
define 接收一个依赖数组和一个定义函数,定义函数的参数按数组顺序接收对应的依赖对象:
define(["logger"], function(logger) {
  return {
    firstName: "John",
    lastName: "Black",
    sayHello: function () {
      logger.log('hello');
    }
  };
});
这里声明了对 logger 模块的依赖,形参 logger 会被自动填充为该模块的导出值。模块通过 return 暴露 API:两个属性和一个方法。此后其他模块只要按 ID 引用它,就能拿到这份 API。
用 require 读取依赖
如果你只是想在某个场景下用到某个库,而不需要产出一个模块,用 require 就够了:
require(['jquery'], function ($) {
  // jQuery 已加载完成,此处可以放心使用
});
写在最后
RequireJS 的价值不只是"按顺序加载文件"。它真正改变的是编码习惯:当你必须显式声明依赖、显式导出接口时,代码自然就变得低耦合、可复用、可测试。
今天浏览器已经原生支持 ES Module,构建工具也大多内置了代码分割与按需加载,RequireJS 的直接使用场景确实少了很多。但 AMD 传递的那套思想——依赖显式化、模块自治、按需加载——依然是理解现代前端工程化的基础。读懂它,再看 import 与打包器的 chunk 策略,很多东西会豁然开朗。
- 上一篇文章: RequireJS 專案優化實戰:合併與壓縮建置流程
- 下一篇文章: JavaScript 如何正确阻止 a 标签的默认跳转行为
相關文章
-
requirejs + vue 專案建置實戰詳解 JavaScript 模塊化編程:CommonJS 與 AMD 規範解析 LABjs、RequireJS 與 SeaJS 的差別:檔案載入器與模組載入器的分野 JavaScript 框架設計:五大分類與核心功能 用 RequireJS 實作 JavaScript 模組化與延遲載入 用 RequireJS 在 JavaScript 應用中實作延遲載入 用 RequireJS 重整你的 JavaScript 引用結構 優化 RequireJS 專案:用 r.js 合併與壓縮腳本 RequireJS 入門指南:用 AMD 馴服 JavaScript 依賴 AMD 非同步模組定義與在 Require.js 中載入 jQuery 及外掛的完整做法