一、Unicode 是什麼?
Unicode 源於一個非常單純的想法:把全世界所有的字元都收進同一個集合裡。只要電腦支援這一個字元集,就能顯示所有文字,從此告別亂碼。

它從 0 開始,為每個符號指定一個編號,這個編號稱為「碼點」(code point)。例如碼點 0 對應的符號就是 null(表示所有二進位位元組都是 0)。
U+0000 = null式中 U+ 表示緊接在後面的十六進位數字是一個 Unicode 碼點。
目前 Unicode 已發展至 7.0 版,共收錄 109449 個符號,其中中日韓文字就佔了 74500 個。可以粗略地說,全世界現有符號中有三分之二以上來自東亞文字。例如中文「好」的碼點是十六進位的 5 9 7 D。
U+597D = 好符號這麼多,Unicode 當然不是一次定義完畢,而是「分區」定義。每個區可容納 65536(2 的 16 次方)個字元,稱為一個「平面」(plane)。目前共有 17(2 的 5 次方)個平面,也就是說整個 Unicode 字元集的容量是 2 的 21 次方。
最前面的 65536 個字元位稱為「基本平面」(BMP,Basic Multilingual Plane),碼點範圍從 0 到 2 的 16 次方減 1,寫成十六進位就是 U+0000 到 U+FFFF。所有最常見的字元都放在這個平面,它也是 Unicode 最先定義並公布的一個平面。
其餘字元則放在「輔助平面」(SMP),碼點範圍從 U+010000 一路到 U+10FFFF。
二、UTF-32 與 UTF-8
Unicode 只規定了每個字元的碼點,至於實際要用什麼樣的位元組序列來表示它,屬於「編碼方法」的範疇。
最直觀的編碼法是每個碼點一律用四個位元組表示,位元組內容與碼點一一對應,這就是 UTF-32。例如碼點 0 就用四個 0 表示,碼點 597D 則在前面補兩個 0。
U+0000 = 0x0000 0000
U+597D = 0x0000 597D
UTF-32 的優點是轉換規則簡單直觀、查詢效率高;缺點則是極度浪費空間——同樣內容的英文文件,它會比 ASCII 編碼大上四倍。這個缺點太致命,導致實務上幾乎沒有人使用,HTML5 標準甚至明文規定網頁不得編碼成 UTF-32。
人們真正需要的是一種省空間的編碼方式,於是 UTF-8 應運而生。UTF-8 是「變長」編碼,字元長度從 1 到 4 個位元組不等,愈常用的字元位元組數愈少,最前面的 128 個字元只用 1 個位元組表示,與 ASCII 完全相同。
編號範圍                 位元組數
0x0000   - 0x007F        1
0x0080   - 0x07FF        2
0x0800   - 0xFFFF        3
0x010000 - 0x10FFFF      4
正因為這種省空間的特性,UTF-8 成為網際網路上最常見的網頁編碼。
三、UTF-16 簡介
UTF-16 的編碼方式介於 UTF-32 與 UTF-8 之間,同時結合了定長與變長兩種編碼法的特點。
它的規則很簡單:基本平面的字元佔 2 個位元組,輔助平面的字元佔 4 個位元組。也就是說,UTF-16 的編碼長度要嘛是 2 個位元組(U+0000 到 U+FFFF),要嘛是 4 個位元組(U+010000 到 U+10FFFF)。
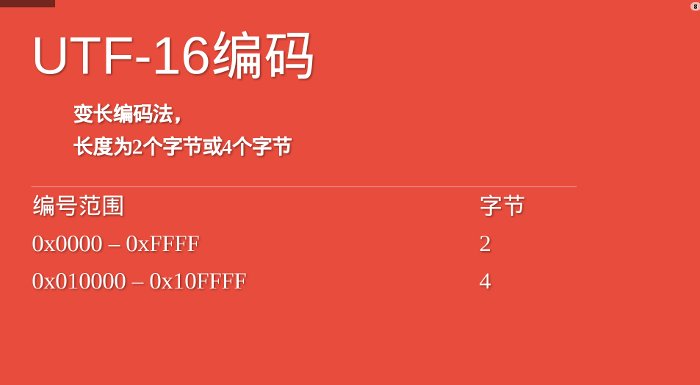
於是就出現一個問題:當我們讀到兩個位元組時,怎麼判斷它「本身就是一個完整字元」,還是「需要跟後面兩個位元組合起來看」?
設計上相當巧妙:在基本平面內,從 U+D800 到 U+DFFF 是一段「空段」,這些碼點不對應任何字元。於是這段空白就被拿來映射輔助平面的字元。
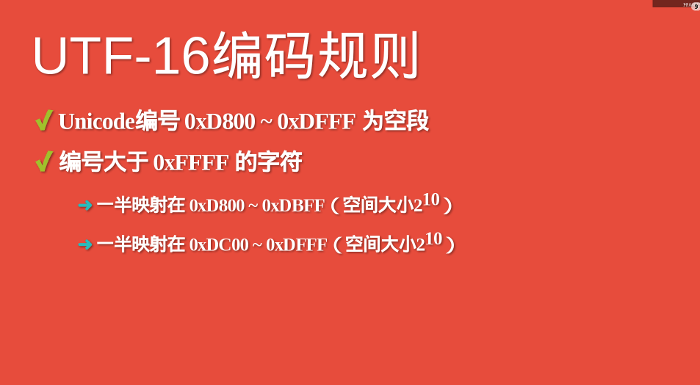
具體來說,輔助平面共有 2 的 20 次方個字元位,至少需要 20 個二進位位元來表示。UTF-16 把這 20 個位元拆成兩半:前 10 位映射到 U+D800 到 U+DBFF(空間大小 2 的 10 次方),稱為「高位」;後 10 位映射到 U+DC00 到 U+DFFF(同樣是 2 的 10 次方),稱為「低位」。這意味著一個輔助平面字元,會被拆成兩個基本平面字元來表示——這就是所謂的「代理對」(surrogate pair)。
所以當我們讀到兩個位元組,發現它的碼點落在 U+D800 到 U+DBFF 之間,就能斷定緊接在後面的兩個位元組必定落在 U+DC00 到 U+DFFF 之間,這四個位元組必須合起來解讀。
四、UTF-16 的轉碼公式
Unicode 碼點轉成 UTF-16 時,首先要區分是基本平面還是輔助平面字元。若是前者,直接轉成對應的十六進位形式,長度為 2 個位元組。
U+597D = 0x597D若是輔助平面字元,Unicode 3.0 版提供了明確的轉碼公式:
H = Math.floor((c - 0x10000) / 0x400) + 0xD800
L = (c - 0x10000) % 0x400 + 0xDC00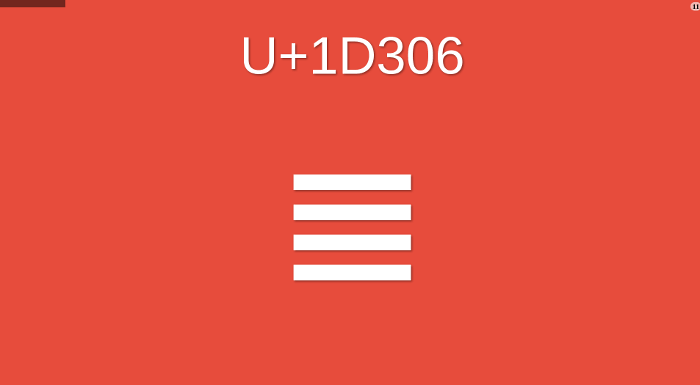
以下圖這個字元為例,它屬於輔助平面,碼點為 U+1D306,轉換過程如下:
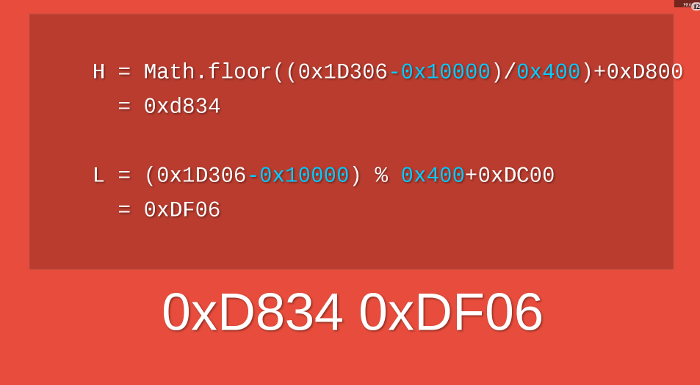
H = Math.floor((0x1D306 - 0x10000) / 0x400) + 0xD800 = 0xD834
L = (0x1D306 - 0x10000) % 0x400 + 0xDC00 = 0xDF06
所以這個字元的 UTF-16 編碼是 0xD834 DF06,長度為 4 個位元組。

五、JavaScript 用的是哪一種編碼?
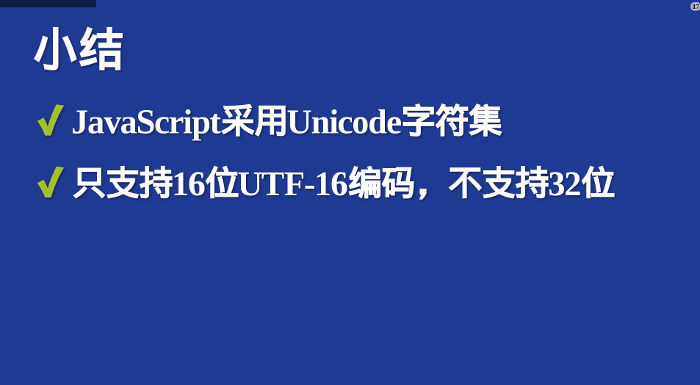
JavaScript 採用 Unicode 字元集,但只支援「一種」編碼方法。而這種編碼既不是 UTF-16,也不是 UTF-8,更不是 UTF-32——上面那些它統統不用。
JavaScript 用的是 UCS-2!
六、UCS-2 編碼的由來
怎麼會突然冒出一個 UCS-2?這得從一點歷史說起。
在網際網路還沒出現的年代,曾經有兩個團隊不約而同地想做「統一字元集」:一個是 1988 年成立的 Unicode 團隊,另一個是 1989 年成立的 UCS 團隊。等到他們發現對方的存在,很快達成共識——世界上不需要兩套統一字元集。
1991 年 10 月,兩個團隊決定合併字元集:從此只發布一套,也就是 Unicode,並修訂先前發布的內容,使 UCS 的碼點與 Unicode 完全一致。

UCS 的開發進度快於 Unicode,1990 年就公布了第一套編碼方法 UCS-2,用 2 個位元組表示當時所有已定義碼點的字元(那時只有一個平面,所以 2 個位元組確實夠用)。UTF-16 則遲至 1996 年 7 月才公布,並明確宣示自己是 UCS-2 的超集:基本平面字元沿用 UCS-2 編碼,輔助平面字元另外定義了 4 個位元組的表示法。
兩者的關係簡單說:UTF-16 取代了 UCS-2,或者說 UCS-2 被整合進了 UTF-16。所以現在只有 UTF-16,已經沒有 UCS-2 了。
七、JavaScript 的誕生背景
那麼問題來了:為什麼 JavaScript 不選更高級的 UTF-16,反而用了已被淘汰的 UCS-2?
答案很無奈:非不願也,實不能也。因為在 JavaScript 這個語言出現的當下,UTF-16 根本還不存在。
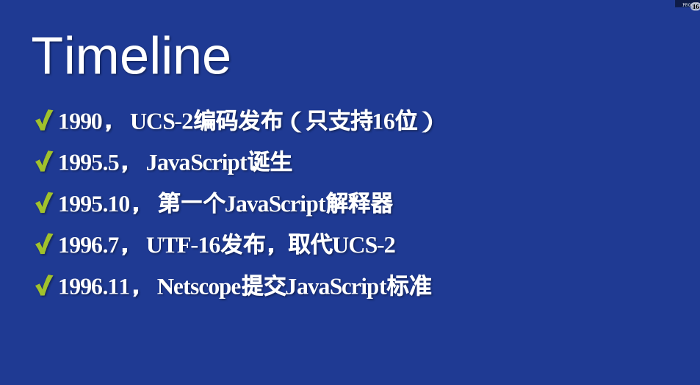
時間軸對比就一目了然:1995 年 5 月,Brendan Eich 用 10 天設計出 JavaScript;同年 10 月,第一個解譯引擎問世;1996 年 11 月,Netscape 正式向 ECMA 提交語言標準。而 UTF-16 直到 1996 年 7 月才發布——Netscape 當時別無選擇,唯一可用的編碼方法就是 UCS-2。
八、JavaScript 字元函數的局限
由於 JavaScript 只能處理 UCS-2 編碼,造成所有字元在這門語言中都是 2 個位元組;如果是 4 個位元組的字元,就會被當成兩個雙位元組字元來處理。JavaScript 的字元函數全都受此影響,無法回傳正確結果。
還是以圖中那個字元為例,它的 UTF-16 編碼是 4 個位元組的 0xD834DF06。問題就在這裡:4 個位元組的編碼不屬於 UCS-2,JavaScript 不認識,只會把它看作兩個獨立字元 U+D834 與 U+DF06。而前面說過,這兩個碼點是空段,所以 JavaScript 會認為它是「兩個空字元組成的字串」!
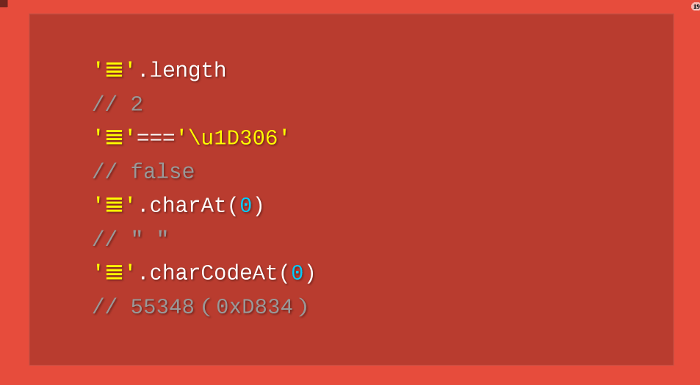
也就是說,JavaScript 認為該字元的長度是 2,取到的「第一個字元」是空字元,而它的碼點被算成 0xD834——這些結果全都錯了。
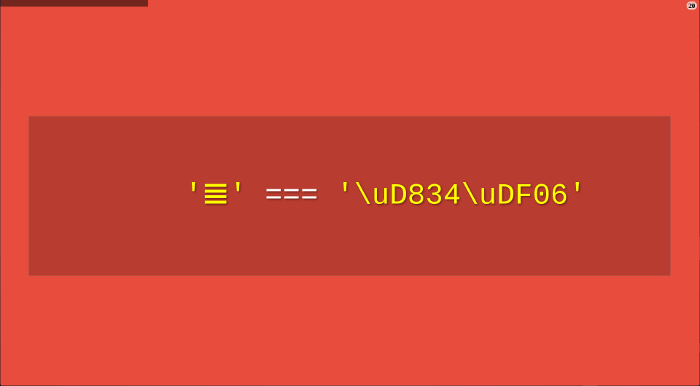
要解決這個問題,必須手動判斷碼點並做調整。以下是正確的字串走訪寫法:
while (++index < length) {
  // ...
  if (charCode >= 0xD800 && charCode <= 0xDBFF) {
    output.push(character + string.charAt(++index));   // 高位代理,連同下一位一起讀
  } else {
    output.push(character);
  }
}
關鍵在於:走訪字串時必須判斷碼點,只要落在 0xD800 到 0xDBFF 這個高位代理區間,就要連著後面 2 個位元組一起讀取。
類似問題存在於「所有」的 JavaScript 字元操作函數,例如:
String.prototype.replace()String.prototype.substring()String.prototype.slice()
這些函數都只對 2 位元組的碼點有效。想正確處理 4 位元組碼點,就必須逐一實作自己的版本,在裡頭判斷目前字元的碼點範圍。
九、ECMAScript 6 的改善
JavaScript 的下一個版本 ECMAScript 6(ES6)大幅增強了 Unicode 支援,基本上解決了上述問題。
(1)正確識別字元
ES6 能自動識別 4 位元組的碼點,走訪字串因此變得單純:
for (let s of string) {
  // ...
}但為了向後相容,length 屬性的行為維持不變。若要取得字串「真正的長度」,可以這樣寫:
Array.from(string).length(2)碼點表示法
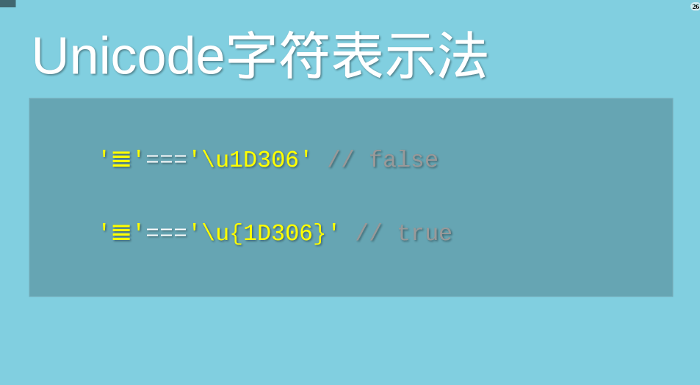
JavaScript 很早以前就允許用碼點表示 Unicode 字元,寫法是「反斜線 + u + 碼點」:
'好' === '\u597D' // true但這種寫法對 4 位元組碼點無效。ES6 修正了這一點:只要把碼點放在大括號內,就能正確識別。
(3)新增字串處理函數
ES6 補上了幾個專門處理 4 位元組碼點的函數:
String.fromCodePoint():從 Unicode 碼點回傳對應字元String.prototype.codePointAt():從字元回傳對應碼點String.prototype.at():回傳字串中指定位置的單一字元
(4)正規表達式
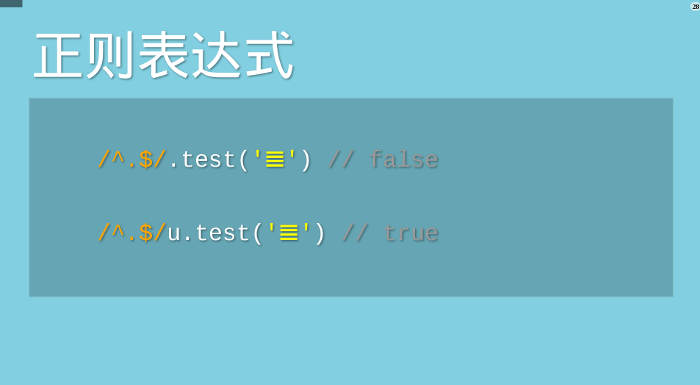
ES6 提供了 u 修飾符,為正規表達式加上 4 位元組碼點的支援。
(5)Unicode 正規化
有些字元除了字母本體之外,還帶有附加符號。比如漢語拼音的 Ǒ,字母上方的聲調符號就是附加符號。對許多歐洲語言而言,這些符號極為重要。
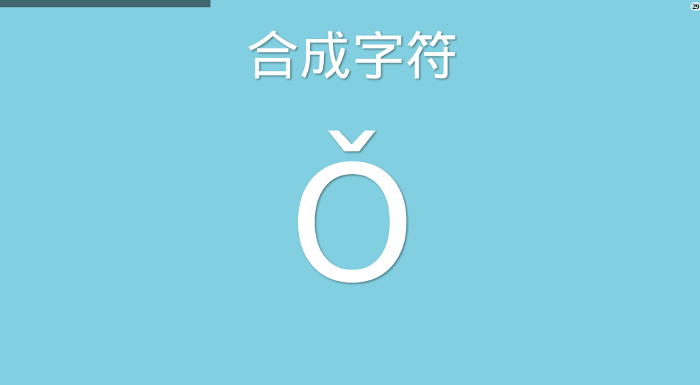
Unicode 對此提供了兩種表示法。一種是用單一字元表示,一個碼點代表一個字元,例如 Ǒ 的碼點是 U+01D1;另一種是把附加符號獨立成一個碼點,與主體字元複合顯示,也就是用兩個碼點表示一個字元,例如 Ǒ 可以寫成 O(U+004F)加上 ˇ(U+030C)。
// 方法一
'\u01D1'          // Ǒ

// 方法二
'\u004F\u030C'    // Ǒ
這兩種寫法在視覺與語義上完全相同,理應被視為等價。但 JavaScript 分不出差別:
'\u01D1' === '\u004F\u030C' // falseES6 提供了 normalize() 方法,允許進行「Unicode 正規化」,把兩種寫法轉成同樣的序列:
'\u01D1'.normalize() === '\u004F\u030C'.normalize() // true回顧這段歷史會發現,JavaScript 在 Unicode 上的種種彆扭之處,根源往往不是設計失誤,而是它誕生在標準尚未成熟的年代。理解這層背景,比死記 API 行為更有價值。