之前聽說 Firefox 的 JS 引擎支援 for each...in 語法,例如:
var arr = [10, 20, 30, 40, 50];
for each (var k in arr)
  console.log(k);
這樣就能直接走訪出 arr 陣列的內容。由於只有 Firefox 支援,所以幾乎所有 JavaScript 程式碼都不用這個特性。
不过在 ActionScript 裡天生就支援 for each 語法,無論是 Array、Vector 還是 Dictionary,只要是可列舉的物件,都能用 for-in 與 for-each-in。
過去並沒感受到太大差異,為了少敲一個 each 單字,一直用熟悉的 for-in 來走訪。不過仔細琢磨之後,從資料結構的角度分析,兩者在效率上有著本質上的區別——無論是 JS 還是 AS。
原因很簡單:Array 不是真正意義上的陣列
何謂真正意義的陣列?就是傳統語言裡以 type[] 定義的資料型別,所有元素在記憶體中連續存放。
「Array」雖然也叫陣列,但熟悉 JavaScript 的人都知道,它其實是個非線性的偽陣列,索引可以是任意數字。寫入 arr[1000000] 並非真的配置能容納一百萬個元素的空間,而是把 1000000 轉換成對應的雜湊值,映射到很小的一塊儲存空間裡,從而省下大量記憶體。
例如有如下陣列:
var arr = [];
arr[10]  = 1000;
arr[20]  = 2000;
arr[30]  = 5000;
arr[40]  = 8000;
arr[200] = 9000;
用 for...in 走訪 Array,是個挺累贅的過程:
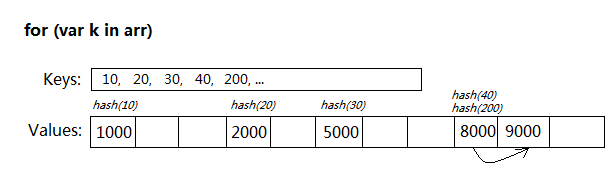
走訪時每次存取 arr[k],都要進行一次 Hash(k) 計算,根據雜湊表容量取模,最終在衝突鏈表裡找到結果。
如果支援 for each...in 語法,其內部的資料結構就決定了它會快很多:
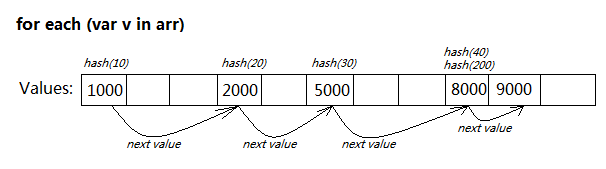
Array 裡儲存了一份 keys 的列表,也把每個 value 作為鏈表關聯起來。每當有值被加入或刪除,就更新其鏈接關係。
當 for each...in 走訪時,只需從第一個節點往後迭代即可,完全不需要任何 Hash 計算。
當然,對於 AS3 裡 Vector 這種線性陣列而言,兩者相差不大;同理,HTML5 中支援二進位的 ArrayBuffer 也是如此。不過從理論上來看,即使 arr 是個連續的線性陣列,for each in 還是要快一點:
for...in 走訪時,每次存取 arr[k] 都要進行索引越界檢查;而 for each in 則根據內部鏈表,直接從底層回饋出迭代變數,省下了越界檢查的過程。
今天的回頭對照
這篇分析的對象是 Firefox 曾經支援、後因使用率過低而移除的 for each...in,因此今天已無法在瀏覽器中執行。但它的推論過程依然有價值,因為它點出了一個經常被忽略的事實:走訪成本取決於資料結構,而不只是語法長相。
在現代 JavaScript 中,這個洞察的具體體現是:走訪真正的陣列時,for (let i = 0; i < arr.length; i++) 或 for...of 走的是索引與迭代器,不需要雜湊計算,因此比 for...in 快得多——更別提 for...in 還會把原型鏈上可列舉的屬性一起走列出來,這是它應該被避免走訪陣列的主因。反之,若你手上是一個 Map 或普通物件,那麼對應的迭代方式本來就是以鏈表或雜湊為基礎,差異自然呈現不同的面貌。
換句話說:先問「我的資料長什麼樣子」,再決定「用哪種走訪方式」,永遠比死記哪個語法比較快來得可靠。
- 上一篇文章: DOM 程式設計:動態建立與刪除元素的做法
- 下一篇文章: eval 與 new Function 該如何取捨?實測效能全面解析