從網路爬蟲原理看SEO優化重點
編輯:關於SEO
了解搜尋引擎爬蟲的工作方式,能幫助我們更科學地進行SEO優化。爬蟲會持續抓取網頁、更新索引,並依規則判斷內容價值。
爬蟲的基本概念
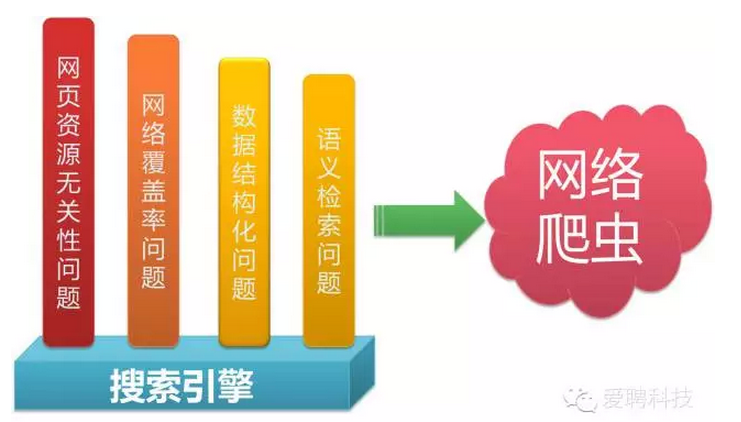
爬蟲是一種抓取網頁的程式,會在網際網路中漫遊、蒐集資訊,並定期更新舊資料,以避免失效連結。常見爬蟲包括Baiduspider、Googlebot等。
爬蟲組成與類型
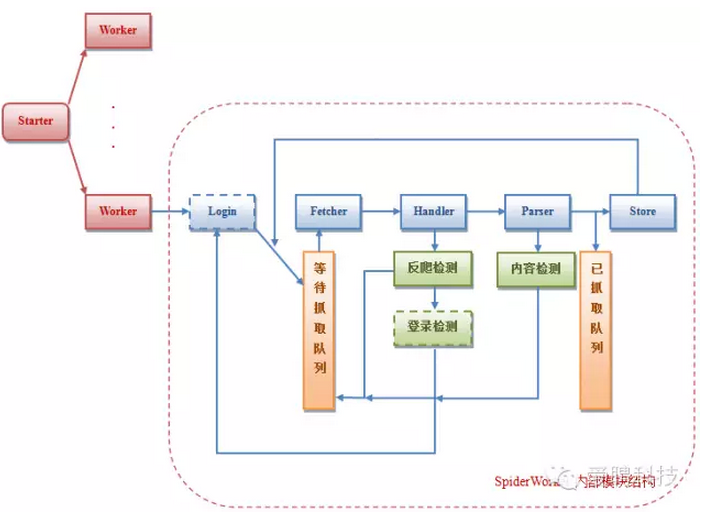
網路爬蟲通常由控制器、解析器與資源庫組成。控制器負責分配任務,解析器負責下載與分析網頁,資源庫則儲存抓取結果。
常見類型包括傳統爬蟲與聚焦爬蟲。傳統爬蟲從起始URL開始抓取;聚焦爬蟲會依主題過濾無關連結,直到達到停止條件。
抓取對象與成本
爬蟲會抓取靜態網頁、動態網頁、文件對象與特殊內容,例如RSS、XML等。若爬蟲頻率過高,可能造成頻寬消耗、伺服器負載,甚至影響網站穩定性。
爬蟲質量與策略
爬蟲目標是提升頁面新鮮度,降低過時性。常見抓取策略包括深度優先、廣度優先與最佳優先。實際應用中,廣度優先與最佳優先較常見。
協議與狀態碼
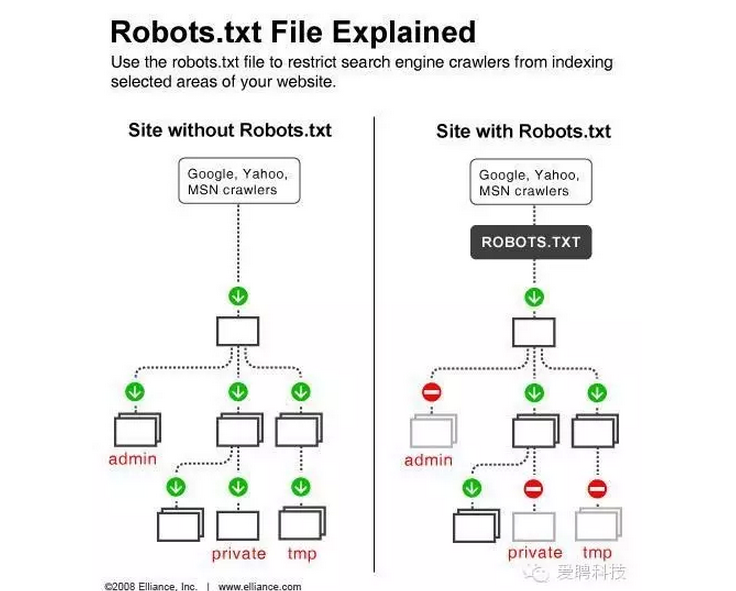
Robots協議用於告訴搜尋引擎哪些頁面可抓取、哪些不可抓取。HTTP狀態碼則反映請求結果,例如200成功、301永久重定向、302暫時重定向、404未找到、5XX伺服器錯誤等。
對SEO而言,應確保重要頁面可被抓取、狀態碼正確、網站結構清楚,並避免大量無效連結或錯誤頁面影響抓取效率。
- 上一篇文章: SEO新手如何寫出一份高水準的SEO方案書
- 下一篇文章: 網站SEO診斷分析:我們的網站是否符合搜索引擎要求