身為軟體開發者,對網路應用如何運作應該有一個分層的完整認知,包含瀏覽器、HTTP、HTML、網路伺服器與請求處理等環節。本文就從「在網址列輸入一個網址並按下 Enter」這個最日常的動作切入,把後台發生的事情依序拆開來看。
1. 在瀏覽器輸入網址
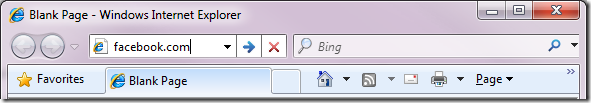
2. 查詢網域的 IP 位址

導航的第一步,是把網域名稱換算成 IP 位址。DNS 查詢的順序大致如下:
- 瀏覽器快取:瀏覽器會把 DNS 記錄快取一段時間。有趣的地方在於,作業系統並不會告訴瀏覽器該快取多久,因此各家瀏覽器各自維護一個固定時長,大約在 2 分鐘到 30 分鐘之間。
- 系統快取:若瀏覽器快取裡找不到,瀏覽器會發出系統呼叫(在 Windows 上是
gethostbyname),以取得系統快取中的記錄。 - 路由器快取:接著查詢會往路由器走,它通常也有自己的 DNS 快取。
- ISP DNS 快取:再接下來檢查的是 ISP 的 DNS 伺服器,這裡往往就能找到對應的記錄。
- 遞迴搜尋:若前面都沒有命中,ISP 的 DNS 伺服器會從根網域伺服器開始遞迴搜尋,一路從
.com頂級網域找到目標網站的權威伺服器。由於多數 DNS 伺服器的快取中已經有.com的位址,實際上到頂層比對的次數並不多。
DNS 遞迴查詢的過程如下圖:

這裡有個值得留意的問題:像 wikipedia.org 或 facebook.com 這種整個網域看起來只對應單一 IP 的情況,容易形成瓶頸。好在有幾種方式可以緩解:
- 循環 DNS(Round Robin DNS):讓一次查詢回傳多個 IP,由用戶端輪流使用。以 Facebook 為例,其網域實際對應多個位址。
- 負載平衡器:這是監聽在特定 IP 上、負責把網路請求轉發到整批伺服器的硬體設備。大型網站通常會採用這類高階且成本不低的方案。
- 地理 DNS:依使用者所在地理位置,把同一網域映射到不同 IP,藉此提升可擴充性。缺點是各節點之間無法即時同步狀態,但對靜態內容來說非常合適。
- Anycast:讓一個 IP 位址對應多台實體主機的路由技術。美中不足的是它與 TCP 協定的配合不算理想,因此很少用在這類情境;不過多數 DNS 伺服器仍會用 Anycast 來達成高效率、低延遲的查詢。
3. 瀏覽器送出 HTTP 請求

像 Facebook 首頁這種動態頁面,快取很快就會過期甚至立刻失效,因此顯然無法從快取讀取,瀏覽器只能把請求送到伺服器:
GET https://facebook.com/ HTTP/1.1
Accept: application/x-ms-application, image/jpeg, application/xaml+xml, [...]
User-Agent: Mozilla/4.0 (compatible; MSIE 8.0; Windows NT 6.1; WOW64; [...]
Accept-Encoding: gzip, deflate
Connection: Keep-Alive
Host: facebook.com
Cookie: datr=1265876274-[...]; locale=en_US; lsd=WW[...]; c_user=2101[...]
GET 後面定義了要讀取的 URL;User-Agent 標頭說明瀏覽器自身的身分;Accept 與 Accept-Encoding 表明它能接受哪些類型的回應與壓縮方式;Connection 則要求伺服器為了後續請求不要關閉 TCP 連線。
請求中還包含瀏覽器為該網域儲存的 cookies。cookies 是一組鍵值對,用來對應跨頁面的網站狀態,裡面可能存著使用者名稱、伺服器核發的識別碼與各項偏好設定。它們以文字檔形式存在用戶端,每次請求時一併送出。
想看原始 HTTP 請求與回應,市面上有不少工具,例如 fiddler 或 FireBug,在網站優化時特別有幫助。
除了讀取,還有另一種「發送」請求(POST),常見於表單提交。它會把參數放在網址中(例如 https://robozzle.com/puzzle.aspx?id=85),或者放在請求本文中送出。
另外別忽略網址結尾那個斜線。https://facebook.com/ 的斜線至關重要,因為瀏覽器可以安全地自行補上;但像 https://example.com/folderOrFile 這種,瀏覽器無法判斷 folderOrFile 到底是資料夾還是檔案,於是只能原樣送出,伺服器再回應一個重新導向——結果就多了一次不必要的往返。
4. 伺服器的永久重新導向回應

圖中所示為 Facebook 伺服器回給瀏覽器的回應:
HTTP/1.1 301 Moved Permanently
Cache-Control: private, no-store, no-cache, must-revalidate, post-check=0,
pre-check=0
Expires: Sat, 01 Jan 2000 00:00:00 GMT
Location: https://www.facebook.com/
P3P: CP="DSP LAW"
Pragma: no-cache
Set-Cookie: made_write_conn=deleted; expires=Thu, 12-Feb-2009 05:09:50 GMT;
path=/; domain=.facebook.com; httponly
Content-Type: text/html; charset=utf-8
X-Cnection: close
Date: Fri, 12 Feb 2010 05:09:51 GMT
Content-Length: 0
伺服器回了一個 301 永久重新導向,瀏覽器於是改往 https://www.facebook.com/ 前進。
為什麼伺服器不直接回傳使用者想看的內容,而要多繞這一圈?原因有幾個:
其一是搜尋引擎排名。如果一個頁面同時有 https://www.igoro.com/ 和 https://igoro.com/ 兩個入口,搜尋引擎會把它們當成兩個網站,導致各自的連結分數被分散、排名下降。而搜尋引擎理解 301 永久重新導向的含義,會把帶 www 與不帶 www 的位址歸在同一個網站底下計算。
其二則是快取友善度。同一個頁面若有多個名字,就可能在看快取中被存成好幾份。
5. 瀏覽器跟著重新導向走

現在瀏覽器知道 https://www.facebook.com/ 才是正確位址,於是按照回應中的 Location 再送一次請求:
GET https://www.facebook.com/ HTTP/1.1
Accept: application/x-ms-application, image/jpeg, application/xaml+xml, [...]
Accept-Language: en-US
User-Agent: Mozilla/4.0 (compatible; MSIE 8.0; Windows NT 6.1; WOW64; [...]
Accept-Encoding: gzip, deflate
Connection: Keep-Alive
Cookie: lsd=XW[...]; c_user=21[...]; x-referer=[...]
Host: www.facebook.com
各標頭的意義與前一次相同。
6. 伺服器「處理」這個請求

伺服器收到請求後進行處理並回傳結果。表面上看這只是個直向的流程,實際上中間的細節相當豐富——像作者自己的部落格這種小站是這樣,流量龐大的 Facebook 更是如此。
Web 伺服器軟體:IIS、Apache 這類伺服器軟體收到 HTTP 請求後,要決定由哪個請求處理程式來接手。請求處理程式就是能讀懂請求並產生 HTML 回應的程式,例如 ASP.NET、PHP、Ruby。最單純的做法是把網址結構對應到檔案層級,例如 https://example.com/folder1/page1.aspx 對應到 /httpdocs/folder1/page1.aspx。伺服器也可以設定成人工對應,讓 page1.aspx 對外發布為 https://example.com/folder1/page1。
請求處理:請求處理程式會讀取請求、參數與 cookies,接著讀取甚至更新伺服器上的資料,最後產生 HTML 回應。
所有動態網站都會碰到同一個難題:資料要怎麼存。小型網站通常只用一個 SQL 資料庫就够了;資料量大或流量高的網站則得想辦法把資料庫分散到多台機器上,常見手段包括分片(依主鍵值把資料表分散到多個資料庫)、複寫,以及採用弱化一致性以簡化設計的資料庫。
把一部分工作交給批次處理,是保持資料更新又控制成本的做法。舉例來說,Facebook 的新聞動態必須即時更新,但「你可能認識的人」這類功能每晚跑一次即可。批次作業會讓部分次要資料略為陳舊,卻能讓整體更新流程更快也更簡潔。
7. 伺服器回傳 HTML 回應

伺服器產生並回傳的回應如下:
HTTP/1.1 200 OK
Cache-Control: private, no-store, no-cache, must-revalidate, post-check=0,
pre-check=0
Expires: Sat, 01 Jan 2000 00:00:00 GMT
P3P: CP="DSP LAW"
Pragma: no-cache
Content-Encoding: gzip
Content-Type: text/html; charset=utf-8
X-Cnection: close
Transfer-Encoding: chunked
Date: Fri, 12 Feb 2010 09:05:55 GMT

2b3Tn@[...]
整個回應約 35kB,其中大部分在整理後以 blob 形式傳輸。Content-Encoding 標頭告知瀏覽器回應本文使用 gzip 壓縮;解開 blob 區塊後,就能看到期望中的 HTML:
<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Strict//EN"
 "https://www.w3.org/TR/xhtml1/DTD/xhtml1-strict.dtd">
<html xmlns="https://www.w3.org/1999/xhtml" xml:lang="en"
lang="en" id="facebook" class=" no_js">
<head>
<meta http-equiv="Content-type" content="text/html; charset=utf-8" />
<meta http-equiv="Content-language" content="en" />
...
標頭同時說明了是否要快取這個頁面、快取該如何進行、有哪些 cookies 需要設定(這次的回應中沒有),以及各項隱私相關資訊。
請特別注意回應標頭把 Content-Type 設為 text/html。瀏覽器依此判斷要把內容當成 HTML 來呈現,而不是當成檔案下載;不過它同時也會把網址副檔名等其他線索納入考量。
8. 瀏覽器開始繪製 HTML
事實上,在完整接收整份 HTML 文件之前,瀏覽器就已經開始畫畫面了:

9. 瀏覽器抓取 HTML 中引用的資源

繪製的過程中,瀏覽器會發現需要另外抓取資源的標籤,於是再送出請求。以下是我們造訪 facebook.com 時需要重新抓取的幾個網址:
圖片
https://static.ak.fbcdn.net/rsrc.php/z12E0/hash/8q2anwu7.gif
https://static.ak.fbcdn.net/rsrc.php/zBS5C/hash/7hwy7at6.gif
…
CSS 樣式表
https://static.ak.fbcdn.net/rsrc.php/z448Z/hash/2plh8s4n.css
https://static.ak.fbcdn.net/rsrc.php/zANE1/hash/cvtutcee.css
…
JavaScript 檔案
https://static.ak.fbcdn.net/rsrc.php/zEMOA/hash/c8yzb6ub.js
https://static.ak.fbcdn.net/rsrc.php/z6R9L/hash/cq2lgbs8.js
…
這些位址都要經歷與 HTML 類似的一整套流程:查 DNS、送請求、處理重新導向等等。
但和動態頁面不同,靜態檔案允許瀏覽器快取。有些檔案甚至完全不需要再跟伺服器溝通,直接從快取讀取即可——伺服器的回應裡會帶有保存期限資訊,瀏覽器據此決定快取多久。此外,每個回應還可能帶一個運作方式類似版本號的 ETag 標頭(被請求變數的實體值);如果瀏覽器發現手上檔案的 ETag 已經是最新,就會立刻中止該檔案的傳輸。
猜猜看網址中的 fbcdn.net 代表什麼?答案是「Facebook 內容分發網路」。Facebook 用 CDN 來散布圖片、CSS 與 JavaScript 這類靜態檔案,因此這些檔案會在世界各地多個 CDN 資料中心留下副本。
靜態內容通常佔了網站大部分的頻寬,也最容易複製到各個節點,因此很多網站會採用第三方 CDN。以 Facebook 為例,它的靜態檔案由最大的 CDN 服務商之一 Akamai 託管。你可以試著 ping static.ak.fbcdn.net,回應的可能來自某台 akamai.net 伺服器;有趣的是再 ping 一次,回應的伺服器可能已經換了一台,這說明背後的負載平衡正在運作。
10. 瀏覽器送出非同步(AJAX)請求

在 Web 2.0 的精神之下,頁面畫完了,用戶端與伺服器之間的連繫並沒有中斷。
以 Facebook 的聊天功能為例,它必須持續與伺服器保持聯繫,才能即時更新好友狀態那些亮亮灰灰的小點。為了更新這些狀態,執行在瀏覽器中的 JavaScript 會送出非同步請求。這個請求有固定的位址,形式上是一個依程式邏輯組裝的 GET 或 POST。在 Facebook 的例子裡,用戶端會對 https://www.facebook.com/ajax/chat/buddy_list.php 發出請求,以取得好友的線上狀態。
談到這個模式就不得不提 AJAX,也就是「非同步 JavaScript 與 XML」。至於伺服器為何選用 XML 作為回應格式,其實也沒有一個絕對明確的理由;再舉一例,Facebook 針對非同步請求會直接回傳 JavaScript 程式碼片段。
fiddler 這類工具讓你能觀察瀏覽器送出的非同步請求,而且不只是被動旁觀,你還能修改並重新送出。正因為 AJAX 請求這麼容易被攔下來偽造,那些有計分排行榜的線上遊戲開發者才格外頭痛。(當然,不建議真的這樣去騙人。)
Facebook 的聊天功能也帶出一個關於 AJAX 的有趣問題:如何把資料從伺服器端「推」到用戶端。由於 HTTP 本質上是請求—回應協定,聊天伺服器沒辦法主動把新訊息送給用戶端,於是只能用戶端每隔幾秒去問一次有沒有新訊息。
在這種情境下,「長輪詢(long polling)」是個減輕伺服器負擔的有趣技巧:當被輪詢時若伺服器沒有新訊息,就先不回應、把請求掛著;一旦在逾時之前收到該用戶的新訊息,伺服器就找出那個未完成的請求,把新訊息當成回應送回用戶端。
- 上一篇文章: 用條件注釋讓不同 IE 版本載入各自的腳本與樣式
- 下一篇文章: HTML 標籤語義化:該用什麼標籤,就用什麼標籤