用 PapaParse 讀取 CSV 並以表格呈現在網頁上
編輯:關於JavaScript
上一篇分享了怎麼把 JSON 下載成 CSV,方便管理。但測試人員看了之後反而希望直接在頁面上看到這些任務,而不是下載檔案再用 Excel 開。於是又做了這個把 CSV 讀回來、以表格渲染的頁面。
完整程式碼
<!DOCTYPE html>
<html>
<head>
    <meta http-equiv="Content-Type" content="text/html;charset=utf-8" />
    <title>csv</title>
    <script src="https://code.jquery.com/jquery-1.11.0.min.js"></script>
    <script src="./papaparse.min.js"></script>
    <style>
        html, body { font-size: 14px; font-family: 'Microsoft Yahei', Tahoma, Verdana, simsun, sans-serif; }
        table { width: 85%; margin: 30px auto; }
    </style>
</head>
<body>
    <table id="table" border="1">
        <caption>CSV 轉 JSON</caption>
        <thead>
            <tr>
                <th>Vehicle</th>
                <th>Date</th>
                <th>Location</th>
                <th>Speed</th>
            </tr>
        </thead>
        <tbody></tbody>
    </table>
    <script>
        Papa.parse('./Result.csv', {
            download: true,
            complete: function (results) {
                var data = results.data, html = '';
                // 從第 1 列開始(跳過空行),扣掉最後一筆空白列
                for (var i = 1, _l = data.length - 1; i < _l; i++) {
                    var item = data[i];
                    html += '<tr>'
                        + '<td>' + item[0].substring(1) + '</td>'
                        + '<td>' + item[1].substring(1) + '</td>'
                        + '<td>' + item[2].substring(1) + '</td>'
                        + '<td>' + item[3].substring(1) + '</td>'
                        + '</tr>';
                }
                $('#table tbody').append(html);
            }
        });
    </script>
</body>
</html>
效果預覽
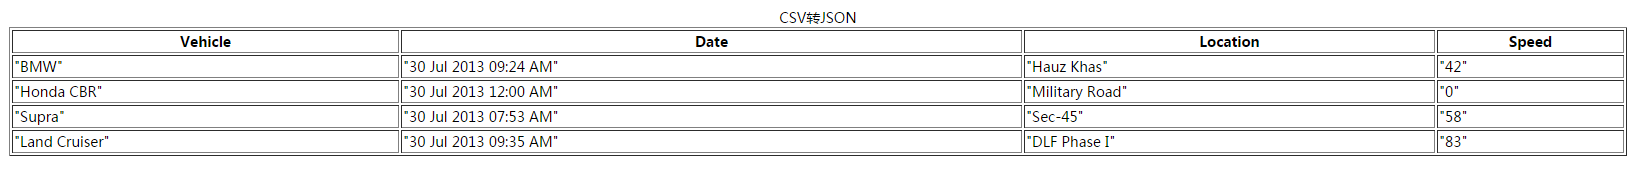
幾個細節說明
為什麼用 PapaParse:瀏覽器本身沒有 CSV 解析器,自己處理引號、逗號、換行的邊界情況很容易出錯。PapaParse 是輕量且成熟的選擇,設定 download: true 就能直接抓網址上的檔案。
為什麼索引從 1 開始、又少跑一筆:這是為了配合上一篇匯出的 CSV——它會多產生一行空行,開頭也可能有額位列。所以迴圈起點設為 1,終點用 data.length - 1 扣掉尾端空白。
為什麼每格都 substring(1):匯出時每個值前面被加了 = 前綴(例如 ="BMW"),這裡用 substring(1) 把第一個字元切掉還原成純值。如果你換成自己格式正常的 CSV,這行就可以移除。
html 變數要初始化:原範例漏了 var html 的初值,會出現 undefined 被拼進字串的情況,上面已補上 html = ''。
執行環境:這個範例需要透過 HTTP 服務開啟,直接用 file:// 雙擊開頁會因為同源政策而抓不到 CSV。用 Node 的 http-server、或任何本機伺服器跑起來即可。
另外提醒,把字串直接拼進 innerHTML 有 XSS 風險。若 CSV 內容來源不可信,建議改用 textContent 逐格建立節點,或引入轉義函式處理后再拼接。
- 上一篇文章: 用 JavaScript 把 JSON 資料匯出成 CSV 檔案
- 下一篇文章: 微信 JS-SDK 介面總整理與使用流程詳解