JavaScript Memoizer 記憶化函式原理剖析
編輯:關於JavaScript
Memoization(記憶化)是一種以空間換時間的技巧:把函式呼叫的結果快取起來,同樣的參數再進來就直接回傳,跳過重算。John Hann 的一段實作把這個想法寫得非常精巧,值得逐層拆解。
原版實作
// memoize: 使用 memoization 來快取的通用方法
// func: 要被快取的方法
// context: 方法執行上下文
// Note: 方法必須是外部可訪問的,參數是可字符序列化的
function memoize (func, context) {
  function memoizeArg (argPos) {   // 參數表示原始方法中參數的位置
    var cache = {};                // key 是參數,value 是執行結果
    return function () {           // 回傳一個閉包
      if (argPos == 0) {
        if (!(arguments[argPos] in cache)) {
          cache[arguments[argPos]] = func.apply(context, arguments);
        }
        return cache[arguments[argPos]];
      } else {
        if (!(arguments[argPos] in cache)) {
          cache[arguments[argPos]] = memoizeArg(argPos - 1);
        }
        return cache[arguments[argPos]].apply(this, arguments);
      }
    };
  }
  var arity = func.arity || func.length;
  return memoizeArg(arity - 1);   // 從最後一個參數開始遞歸
}
使用方式:
var mem = memoize(func, this);
alert(mem.call(this, 1, 1, 2));
alert(mem.call(this, 2, 1, 2));
alert(mem.call(this, 3, 1, 3));
alert(mem.call(this, 2, 2, 4));
它到底建了什麼
關鍵在於「從最後一個參數開始遞歸」。每次呼叫 memoizeArg 都會產生一個帶有獨立 cache 的閉包,而每個 cache 的鍵是該層參數的值。連續幾次呼叫之後,這些閉包串成了一棵樹:每個節點是一個閉包、每個閉包有一個 cache、每個 cache 的鍵就是樹的分支。
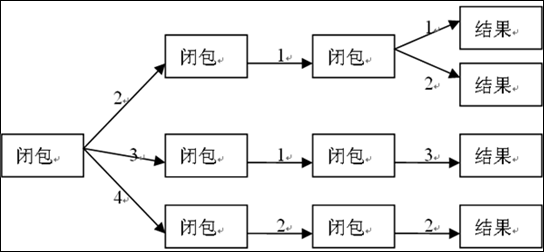
(圖中的「結果」也是一個閉包,只是它的 argPos 為 0。)
這樣設計的好處是:多參數函式的快取不必把整組參數拼成一個字串鍵,而是逐層比對,共用前綴的呼叫可以複用同一批中間節點。
更簡潔的版本
function Memoize(fn){
  var cache = {};
  return function(){
    var key = [];
    for (var i = 0, l = arguments.length; i < l; i++) key.push(arguments[i]);
    if (!(key in cache)) cache[key] = fn.apply(this, arguments);
    return cache[key];
  };
}
程式碼短得多,但把參數 push 進陣列後當成鍵,而物件鍵只支援字串,陣列會被隱式轉成字串。這帶來一個實際問題:傳入物件時,toString() 往往只得到 "[object Object]",不同物件會撞在同一個鍵上,快取因此失效。
補強鍵的問題
function Memoize(fn){
  var cache = {}, args = {};
  return function(){
    for (var i = 0, key = args.length; i < key; i++) {
      if (equal(args[i], arguments)) return cache[i];
    }
    args[key] = arguments;
    cache[key] = fn.apply(this, arguments);
    return cache[key];
  };
}
做法是另立一個參數表,用自增的 ID 把參數組與快取結果關聯起來,比較時改為自寫的 equal 函式。代價是查找變成線性掃描,參數組多時效能會下降。
實務上的注意事項
記憶化並非萬靈丹。它只適合「純函式」——相同輸入必定得到相同輸出、且沒有副作用。若函式回傳的是會變動的物件,快取會讓呼叫端拿到舊參照而產生難以追查的 bug。另外快取沒有上限,長期運行下參數組合無窮多時會造成記憶體持續成長,正式環境通常要加上 LRU 淘汰機制(例如以 Map 實作並在超過門檻時移除最舊的項目)。