JavaScript 十六進位轉換的兩個改進思路
編輯:關於JavaScript
把文字轉成十六進位,最常見的寫法是借用 escape() 再把 % 換成反斜線:
// 將文字轉換為 16 進位
function textToSix(str) {
  return escape(str).replace(/%/g, function () {
    return "\\";
  }).toLowerCase();
}
改進一:加上型別驗證
escape() 在編碼 0–255 以外的 Unicode 字元時,會輸出 %u**** 的形式,例如「執手淚眼」會變成 %u6267%u624b%u6cea%u773c;把其中的 % 換成 \,就得到我們要的十六進位表示。既然函式只對字串有意義,那就該在入口處擋掉非字串輸入:
// 將文字轉換為 16 進位
function textToHex(str) {
  if (typeof str == "string") {
    return escape(str).replace(/%/g, function () {
      return "\\";
    }).toLowerCase();
  } else {
    return null;
  }
}
改進二:反向轉換其實是多此一舉
原本還寫了一個把十六進位還原成文字的方法:
// 將 16 進位表示為文字
function sixToText(str) {
  return unescape(str);
}
但只要理解 unescape 的原理——找出形如 %xx 與 %uxxxx 的序列,用 \u00xx、\uxxxx 取代後解碼——就會發現瀏覽器本身就能解析十六進位字元,這個包裝函式完全沒有必要。

在 IE9 中:
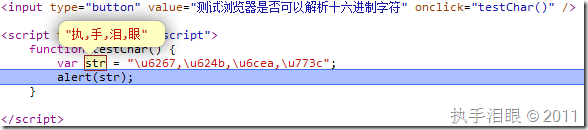
在 Chrome 中:
額外收穫:反斜線會被瀏覽器「吃掉」
原本想先把 \ 還原成 %,再交給 unescape 解碼,過程中卻發現一個有意思的現象:反斜線如果後面沒有接上 t、n 這類能組成轉義字元的字元,會被瀏覽器直接忽略。

在 IE9 中調試:

在 Chrome 下調試:
定義一個含有反斜線的變數,中斷時可以看到瀏覽器很「聰明」地忽略了特殊位置的字元。這提醒我們:把看似平常的字串(例如檔案路徑)直接塞進 JS 變數,輸出結果往往不如預期。
- 上一篇文章: JavaScript 開發隨筆:preventDefault 為什麼不能省
- 下一篇文章: 改造騰訊大粵網首頁:原生 JS 圖片新聞輪播