JavaScript 的字元集
JavaScript 程式是以 Unicode 字元集撰寫的。Unicode 是 ASCII 與 Latin-1 的超集,涵蓋了幾乎所有語言的字符。ECMAScript 3 要求支援 Unicode 2.1 以上版本,ES5 則要求 Unicode 3 以上。所以我們寫出來的 JavaScript 字串,本質上都是 Unicode 編碼。
什麼是 UTF-8
UTF-8(8-bit Unicode Transformation Format)是 Unicode 的一種可變長度編碼,也是一種前綴碼。它能表示 Unicode 中的任何字符,而第一個位元組仍與 ASCII 相容,因此原本處理 ASCII 的軟體幾乎不用修改就能沿用。這也是它成為網頁與電子郵件主流編碼的原因。
為什麼需要轉換
常見情境是:要送一段二進位資料到伺服器,而對方規定內容必須是 UTF-8。這時就得把 JavaScript 的 Unicode 字串轉成 UTF-8 位元組。
編碼結構的差異
Unicode 的編碼長度是固定的:英文字元佔 1 個位元組,漢字佔 2 個位元組(可以用 charCodeAt 驗證)。UTF-8 則依單一字符的大小決定長度,最長可達 6 個位元組:
1 個位元組:Unicode 碼 0 - 127
2 個位元組:128 - 2047
3 個位元組:2048 - 0xFFFF
4 個位元組:65536 - 0x1FFFFF
5 個位元組:0x200000 - 0x3FFFFFF
6 個位元組:0x4000000 - 0x7FFFFFFF
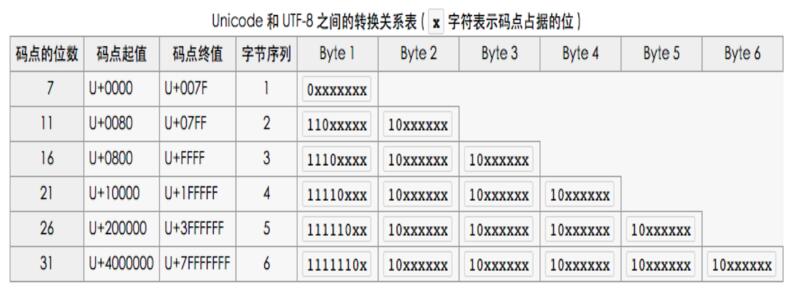
英文的 Unicode 碼落在 0 - 127,所以在兩種編碼中長度一致,都只佔 1 個位元組——這就是 UTF-8 是 Unicode 超集的原因。漢字的碼區在 0x2e80 - 0x9fff,因此最長為 3 個位元組。
動手轉一次「中」
1、取得 Unicode 值
 var str = '中';
 var charCode = str.charCodeAt(0);
 console.log(charCode); // => 20013
2、判斷 UTF-8 長度:20013 落在 2048 - 0xFFFF 之間,所以佔 3 個位元組。
3、補位。UTF-8 的補位模板如下,「x」代表待填的空位:
0xxxxxxx
110xxxxx 10xxxxxx
1110xxxx 10xxxxxx 10xxxxxx
11110xxx 10xxxxxx 10xxxxxx 10xxxxxx
111110xx 10xxxxxx 10xxxxxx 10xxxxxx 10xxxxxx
1111110x 10xxxxxx 10xxxxxx 10xxxxxx 10xxxxxx 10xxxxxx
值得注意:第一個位元組開頭有幾個 1,就代表整段 UTF-8 佔幾個位元組——解碼時正是靠這個特性判斷的。
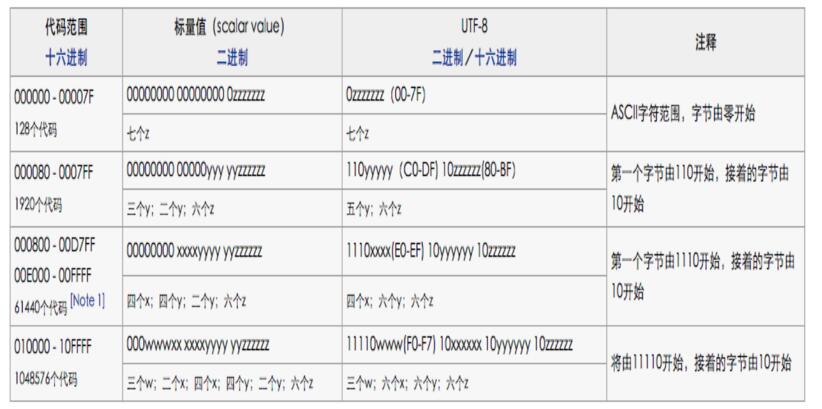
先看簡單的例子,把英文字母「A」轉為 UTF-8:
①「A」的 charCode 為 65;② 落在 0-127,佔 1 個位元組;③ 模板為 0xxxxxxx;④ 65 的二進位是 1000001;⑤ 依序填入空位得到 01000001;⑥ 轉回字元仍是「A」。
再回到「中」。20013 的二進位表示如下:
 var code = 20013;
 code.toString(2); // => "100111000101101",等同 01001110 00101101
依同樣的規則補到 1110xxxx 10xxxxxx 10xxxxxx,得到 11100100 10111000 10101101。
4、把每個位元組轉成 16 進位,即 0xE4 0xB8 0xAD。用 Node.js 的 Buffer 驗證:
 var buffer = new Buffer('中');
 console.log(buffer.length); // => 3
 console.log(buffer);        // => <Buffer e4 b8 ad>
結果與手算完全一致。
把邏輯寫成函式
 // 將字串格式化為 UTF-8 編碼的位元組
 var writeUTF = function (str, isGetBytes) {
   var back = [];
   var byteSize = 0;
   for (var i = 0; i < str.length; i++) {
     var code = str.charCodeAt(i);
     if (0x00 <= code && code <= 0x7f) {
       byteSize += 1;
       back.push(code);
     } else if (0x80 <= code && code <= 0x7ff) {
       byteSize += 2;
       back.push((192 | (31 & (code >> 6))));
       back.push((128 | (63 & code)));
     } else if ((0x800 <= code && code <= 0xd7ff) || (0xe000 <= code && code <= 0xffff)) {
       byteSize += 3;
       back.push((224 | (15 & (code >> 12))));
       back.push((128 | (63 & (code >> 6))));
       back.push((128 | (63 & code)));
     }
   }
   for (i = 0; i < back.length; i++) {
     back[i] &= 0xff;
   }
   if (isGetBytes) {
     return back;
   }
   if (byteSize <= 0xff) {
     return [0, byteSize].concat(back);
   } else {
     return [byteSize >> 8, byteSize & 0xff].concat(back);
   }
 };
 writeUTF('中'); // => [0, 3, 228, 184, 173]
 // 前兩位表示後面 UTF-8 位元組的長度;內容 228,184,173 轉 16 進位即 0xE4 0xB8 0xAD
 // 讀取 UTF-8 位元組並還原為字串
 var readUTF = function (arr) {
   if (typeof arr === 'string') { return arr; }
   var UTF = '', _arr = this.init(arr);
   for (var i = 0; i < _arr.length; i++) {
     var one = _arr[i].toString(2), v = one.match(/^1+?(?=0)/);
     if (v && one.length == 8) {
       var bytesLength = v[0].length;
       var store = _arr[i].toString(2).slice(7 - bytesLength);
       for (var st = 1; st < bytesLength; st++) {
         store += _arr[st + i].toString(2).slice(2);
       }
       UTF += String.fromCharCode(parseInt(store, 2));
       i += bytesLength - 1;
     } else {
       UTF += String.fromCharCode(_arr[i]);
     }
   }
   return UTF;
 };
 readUTF([0, 3, 228, 184, 173]); // => '中'
更省事的做法:借用 encodeURI
其實瀏覽器早就幫我們做好了,而且我們一直在用——就是 encodeURI(encodeURIComponent 亦可)。
 var str = '中';
 var code = encodeURI(str);
 console.log(code); // => "%E4%B8%AD"
得到的轉義字串,內容與前面手算出來的位元組一模一樣。接著只要拆掉百分比符號、轉成數字陣列:
 var codeList = code.split('%').map(item => parseInt(item, 16));
 console.log(codeList); // => [228, 184, 173]
原理是什麼?
這牽涉到 URI 中 querystring 的編碼規範。依規定 URI 的查詢字串必須以 UTF-8 傳輸,而 JavaScript 字串是 Unicode,所以瀏覽器提供了 encodeURI / encodeURIComponent:它會把非英文字元先轉成 UTF-8 位元組,前面加上 % 拼接,於是「中」就成了 %E4%B8%AD。
這個做法有個限制:它只會轉義非英文字元。若需要把英文也一併轉成位元組形式,就得額外處理。要還原時則用 decodeURI / decodeURIComponent:
 var codeList = [228, 184, 173];
 var code = codeList.map(item => '%' + item.toString(16)).join('');
 decodeURI(code); // => 中
最後補充一個實務提醒:new Buffer() 已不建議使用,新專案請改用 Buffer.from();而在瀏覽器端處理位元組,TextEncoder / TextDecoder 是更直接的標準 API。
- 上一篇文章: 一次搞懂 JavaScript 原型鏈與各種繼承寫法
- 下一篇文章: JavaScript 三元運算子:語法、求值規則與常見用法
相關文章
-
JS 失效並出現 HTML1114 錯誤:utf-8 編碼衝突的解決方法 JSP 環境下 AJAX POST 中文亂碼:編碼兩次就通了 中英文並存時行高對不齊?一個 font-family 就能解決 HTML5 入門完全指南:從最精簡的文件到完整的頁面骨架 JavaScript傳遞中文參數出現亂碼的解決之道 用 jQuery qrcode 外掛在網頁動態產生 QR Code JS 的 Unicode 編碼轉換:編解碼函式與背後的原理 比 [\u4e00-\u9fa5] 更完整的中文字元正則表達式 用 JavaScript 取得當前網址的查詢參數 JS encodeURI 函數:URI 編碼與保留字元