淺談用 JavaScript 做語音識別
編輯:關於JavaScript
基礎用法
 var recognition = new webkitSpeechRecognition();
recognition.onresult = function(event) {
 console.log(event)
}
recognition.start();
這段程式碼會讓瀏覽器請求使用者授權開啟麥克風。一旦使用者允許,就可以開始說話;當你停止說話,註冊在 onresult 上的回呼就會被觸發,並把擷取到的音訊包裝成一個 JavaScript 物件回傳。
處理連續語流
實務上你需要「等待使用者準備好」,並且「知道對話何時結束」,這時要開啟兩個選項:
 var recognition = new webkitSpeechRecognition();
recognition.continuous = true;
recognition.interimResults = true;
recognition.onresult = function(event) {
 console.log(event)
}
recognition.start();
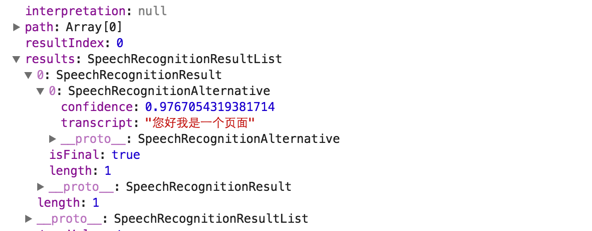
continuous = true 讓辨識不因為短暫停頓就中斷;interimResults = true 則會在辨識過程中就先回傳暫定的結果,讓你能在使用者還在說話時就提前渲染,不必等到整句說完。
辨識語言可以自動依所在地區判斷,也可以透過 recognition.lang 明確指定,例如設為 'zh-TW'。
x-webkit-speech 屬性
Webkit 內核的瀏覽器支援直接寫在輸入框上的語音輸入:
<input type="text" x-webkit-speech />
它會識別音訊並轉換成文字填進欄位裡。
安全性 considerations
在 http 協定下,瀏覽器每次進行語音操作都會跳出確認提示;而 https 頁面則沒有這層反覆打擾。另外要留意,在 JavaScript 上下文中,整個頁面都能存取到擷取的音訊,因此如果頁面載入了第三方腳本,等於把麥克風內容也交了出去——引入外部資源時務必謹慎。
結語
JavaScript 的語音識別目前還未大量普及,一方面受限於瀏覽器支援度(webkitSpeechRecognition 長期只有部分瀏覽器實作),另一方面也需要使用者主動授權麥克風。因此目前只有少數需求會真正用到它。
不過值得注意的是,辨識本身多半是把音訊送到雲端服務處理,這意味著語音內容會離開使用者裝置。在設計此類功能時,最好明確告知使用者並提供替代的文字輸入方式,這既是隱私要求,也是無障礙設計的基本功。
- 上一篇文章: 用 Vuex 與 Vue.js 打造一個筆記單頁應用
- 下一篇文章: JavaScript 滑鼠跟隨三種效果:眼球轉動、蘋果選單、方向跟隨