這份筆記把常見的經典演算法用 JavaScript 重新實作了一遍,從最基礎的線性查找一路寫到堆排序、不相交集合、遞歸與分治法,每個範例都附上時間複雜度說明,適合當作複習與對照的參考。
一、查找
線性查找,時間複雜度 O(n),相當於演算法界的 Hello World:
// A 為陣列,x 為要搜尋的值
function linearSearch(A, x) {
  for (var i = 0; i < A.length; i++) {
    if (A[i] == x) return i;
  }
  return -1;
}
二分查找(折半查找),適用於已排序的線性結構,時間複雜度 O(log n):
// A 為已升冪排序的陣列,回傳目標元素的下標
function binarySearch(A, x) {
  var low = 0, high = A.length - 1;
  while (low <= high) {
    var mid = Math.floor((low + high) / 2);   // 下取整
    if (x == A[mid]) return mid;
    if (x < A[mid]) high = mid - 1;
    else            low  = mid + 1;
  }
  return -1;
}
二、排序
冒泡排序,O(n²)。這裡刻意讓內循環倒著走,並用 sorted 旗標提前結束:
function bubbleSort(A) {
  for (var i = 0; i < A.length; i++) {
    var sorted = true;
    for (var j = A.length - 1; j > i; j--) {
      if (A[j] < A[j - 1]) {
        swap(A, j, j - 1);
        sorted = false;
      }
    }
    if (sorted) return;   // 這一輪沒有交換,代表已排序完成
  }
}
選擇排序,O(n²)。思路是每輪找出最小值的位置再交換:
function selectionSort(A) {
  for (var i = 0; i < A.length - 1; i++) {
    var k = i;
    for (var j = i + 1; j < A.length; j++) {
      if (A[j] < A[k]) k = j;
    }
    if (k != i) {
      var t = A[k]; A[k] = A[i]; A[i] = t;
      println(A);
    }
  }
  return A;
}
插入排序,O(n²)。把當前元素之前的區段視為已排序,比它大的元素往後挪出空位,再把目標插入:
function insertSort(A) {
  for (var i = 1; i < A.length; i++) {
    var x = A[i];
    for (var j = i - 1; j >= 0 && A[j] > x; j--) {
      A[j + 1] = A[j];
    }
    if (A[j + 1] != x) {
      A[j + 1] = x;
      println(A);
    }
  }
  return A;
}
字串反轉,用雙指針從兩端對交換:
// ABC -> CBA
function inverse(s) {
  var arr = s.split('');
  var i = 0, j = arr.length - 1;
  while (i < j) {
    var t = arr[i]; arr[i] = arr[j]; arr[j] = t;
    i++; j--;
  }
  return arr.join('');
}
關於穩定性的常見結論:以比較為基礎、複雜度 O(n²) 的簡單排序通常可視為穩定排序;而歸並排序、堆排序、桶排序這類可優化到 n·log n 的進階演算法,一般被認為是不穩定排序。
三、單向鏈結串列
// 節點類別
var Node = function (v) {
  this.data = v;      // 節點值
  this.next = null;   // 後繼節點
};

var SingleLink = function () {
  this.head = new Node(null);   // 約定頭節點僅佔位,不存值

  // 插入節點(尾插)
  this.insert = function (v) {
    var p = this.head;
    while (p.next != null) p = p.next;
    p.next = new Node(v);
  };

  // 刪除指定位置的節點
  this.removeAt = function (n) {
    if (n <= 0) return;
    var preNode = this.getNodeByIndex(n - 1);
    preNode.next = preNode.next.next;
  };

  // 取第 N 個位置的節點(頭節點為第 0 個)
  this.getNodeByIndex = function (n) {
    var p = this.head, i = 0;
    while (p.next != null && i < n) { p = p.next; i++; }
    return p;
  };

  // 依值查詢,多個相同值時回傳第一個
  this.getNodeByValue = function (v) {
    var p = this.head;
    while (p.next != null) {
      p = p.next;
      if (p.data == v) return p;
    }
    return null;
  };

  this.print = function () {
    var p = this.head;
    while (p.next != null) { p = p.next; print(p.data + " "); }
    println("");
  };
};

// 檢查鏈表中是否有重複元素
function hasSameValueNode(singleLink) {
  var i = singleLink.head;
  while (i.next != null) {
    i = i.next;
    var j = i;
    while (j.next != null) {
      j = j.next;
      if (i.data == j.data) return true;
    }
  }
  return false;
}

// 鏈表反轉
function reverseSingleLink(singleLink) {
  var arr = new Array();
  var p = singleLink.head;
  while (p.next != null) { p = p.next; arr.push(p.data); }
  var newLink = new SingleLink();
  for (var i = arr.length - 1; i >= 0; i--) newLink.insert(arr[i]);
  return newLink;
}

var linkTest = new SingleLink();
linkTest.insert('A'); linkTest.insert('B');
linkTest.insert('C'); linkTest.insert('D');
linkTest.print();                        // A B C D
reverseSingleLink(linkTest).print();     // D C B A
四、圖的儲存方式:鄰接矩陣 vs 鄰接表
兩者都是圖的基本儲存方式。稀疏圖(邊數遠小於頂點數)適合用鄰接表,因為它只存實際存在的邊與頂點,不必浪費 N×N 的空間;稠密圖(邊數遠大於頂點數)則適合鄰接矩陣,避免鏈表來回跳指標造成的額外開銷。
五、堆(Heap)
幾乎完全的二元樹:除了最右側可能缺少一兩個葉節點外,其餘都填滿。物理上可用陣列儲存,若 A[j] 有左右子節點,左子節點為 A[2j]、右子節點為 A[2j+1],父節點則在 A[j/2]。
堆本身是幾乎完全的二元樹,且父節點值不小於子節點值。典型應用是優先佇列、查找最大或次大值、以及插入新元素到優先佇列。以下程式皆約定索引 0 僅佔位,有效元素從下標 1 開始。
// 測試陣列 H 是否為堆,時間複雜度 O(n)
function isHeap(H) {
  if (H.length <= 1) return false;
  var half = Math.floor(H.length / 2);   // 依堆性質只需檢查一半
  for (var i = 1; i <= half; i++) {
    // 父節點比任一個子節點小,即違反堆定義
    if (H[i] < H[2 * i] || H[i] < H[2 * i + 1]) return false;
  }
  return true;
}
當某個元素的值變大(例如 10,8,9,7 中的 7 變成 20)而破壞堆性質時,需要向上調整:
// 堆中的節點上移 siftUp
function siftUp(H, i) {
  if (i <= 1) return;
  for (var j = i; j > 1; j = Math.floor(j / 2)) {
    var k = Math.floor(j / 2);
    if (H[j] > H[k]) {          // 子節點比父節點大,交換
      var t = H[j]; H[j] = H[k]; H[k] = t;
    } else {
      return;                   // 已符合堆定義,調整結束
    }
  }
}
向下調整,時間複雜度 O(log n):
function siftDown(H, i) {
  if (2 * i > H.length) return;   // 葉子節點不必再往下
  for (var j = 2 * i; j < H.length; j = 2 * j) {
    if (H[j + 1] > H[j]) j++;     // 把 j 定位到兩個子節點中較大者
    var k = Math.floor(j / 2);
    if (H[k] < H[j]) {
      var t = H[k]; H[k] = H[j]; H[j] = t;
    } else {
      return;
    }
  }
}

// 新增元素,O(log n)
function insert(H, x) {
  H.push(x);                 // 先放到陣列尾端
  siftUp(H, H.length - 1);   // 再往上推
}

// 刪除指定位置 i 的元素,O(log n)
function remove(H, i) {
  var x = H[i];              // 先把原位置的值保留下來做比較
  H[i] = H.pop();            // 最後一個元素補到 i,同時刪掉尾端
  var n = H.length - 1;
  if (i == n + 1) return;    // 刪的正好是末尾之一,無需調整
  if (H[i] > x) siftUp(H, i); else siftDown(H, i);
}

// 刪除並回傳最大項,O(log n)
function deleteMax(H) {
  var x = H[1];
  remove(H, 1);
  return x;
}
堆排序的精髓在於充分利用「堆首必為最大值」的特性,且每次上移/下調只需 O(log n),又不必額外空間。做法三步驟:
1、把首元素(最大值)與末尾元素對調,讓最大值沉底,之後不再處理它。
2、交換後剩下的元素已不再是合法堆,把新的首元素 siftDown 下調,最大值自然又浮到第一位。
3、重複上述步驟,直到全部有序。
建立堆需 O(n),每次 siftDown 為 O(log n),最多調整 n-1 次,總複雜度為 O(n log n)。
// 帶範圍上限的下調,n 為待處理的有效元素上界
function siftDown(H, i, n) {
  if (n >= H.length) n = H.length;
  if (2 * i > n) return;
  for (var j = 2 * i; j < n; j = 2 * j) {
    if (H[j + 1] > H[j]) j++;
    var k = Math.floor(j / 2);
    if (H[k] < H[j]) {
      var t = H[k]; H[k] = H[j]; H[j] = t;
    } else {
      return;
    }
  }
}

// 對前 n 個元素建堆
function makeHeap(A, n) {
  if (n >= A.length) n = A.length;
  for (var i = Math.floor(n / 2); i >= 1; i--) siftDown(A, i, n);
}

// 堆排序(非降冪),O(n log n)
function heapSort(H) {
  makeHeap(H, H.length);
  for (var j = H.length - 1; j >= 2; j--) {
    var x = H[1]; H[1] = H[j]; H[j] = x;   // 最大值沉底
    siftDown(H, 1, j - 1);                 // 剩餘元素重新維持堆形狀
  }
  return H;
}
建堆也可以用反向思路,由小到大依序 siftUp:
function makeHeap2(A, n) {
  if (n >= A.length) n = A.length;
  for (var i = Math.floor(n / 2); i <= n; i++) siftUp(A, i);
}
六、不相交集合:查找與合併
var Node = function (v, p) {
  this.value  = v;    // 節點值
  this.parent = p;    // 父節點
  this.rank   = 0;    // 秩,預設 0
};

// 查找節點 x 所屬樹的根,並做路徑壓縮
var find = function (x) {
  var y = x;
  while (y.parent != null) y = y.parent;
  var root = y;
  y = x;
  while (y.parent != null) {
    var w = y.parent;   // 先存起來,否則下一步就遺失了
    y.parent = root;    // 把節點直接掛到根下
    y = w;              // 繼續往上壓縮
  }
  return root;
};

// 合併 x、y 所屬的兩個集合
var union = function (x, y) {
  var u = find(x), v = find(y);
  if (u.rank <= v.rank) {
    u.parent = v;
    if (u.rank == v.rank) v.rank += 1;   // 秩相同時,勝方 rank+1
  } else {
    v.parent = u;
  }
};
七、遞歸
先看兩個排序的遞歸版本:
// 選擇排序遞歸版,呼叫方式:selectionSortRec([3,2,1], 0)
function selectionSortRec(A, i) {
  var n = A.length - 1;
  if (i < n) {
    var k = i;
    for (var j = i + 1; j <= n; j++) if (A[j] < A[k]) k = j;
    if (k != i) { var t = A[k]; A[k] = A[i]; A[i] = t; }
    selectionSortRec(A, i + 1);
  }
}

// 插入排序遞歸版,呼叫方式:insertSortRec([4,3,2,1], 3)
function insertSortRec(A, i) {
  if (i > 0) {
    var x = A[i];
    insertSortRec(A, i - 1);
    var j = i - 1;
    while (j >= 0 && A[j] > x) { A[j + 1] = A[j]; j--; }
    A[j + 1] = x;
  }
}

// 遞歸求陣列最大值
function findMax(A, i) {
  if (i == 0) return A[0];
  var y = findMax(A, i - 1);
  var x = A[i - 1];
  return y > x ? y : x;
}
alert(findMax([1,2,3,4,5,6,7,8,9], 9));   // 9

// 已升冪排序的陣列中,是否存在兩數之和恰為 x
function sumX(A, i, j, x) {
  if (i >= j) return false;
  if (A[i] + A[j] == x) return true;
  else if (A[i] + A[j] < x) return sumX(A, i + 1, j, x);  // i 後移
  else                      return sumX(A, i, j - 1, x);  // j 前移
}
alert(sumX([1,2,3,4,5,6,7,8], 0, 7, 9));   // true
遞歸雖好讀,但通常效率較差,多半可以改寫成迴圈版本:
function sumX2(A, x) {
  var i = 0, j = A.length - 1;
  while (i < j) {
    if (A[i] + A[j] == x) return true;
    else if (A[i] + A[j] < x) i++;
    else j--;
  }
  return false;
}
alert(sumX2([1,2,3,4,5,6,7,8], 9));   // true
不過遞歸並不等於低效。計算 x 的 m 次方就是反例:直觀做法需要 m 次乘法,而利用 x^m = [x^(m/2)]² 可以把複雜度降到 O(log n):
function expRec(x, m) {
  if (m == 0) return 1;
  var y = expRec(x, Math.floor(m / 2));
  y = y * y;
  if (m % 2 != 0) y = x * y;
  return y;
}

// 把十進位數轉成二進位字串
function toBin(dec) {
  var bits = [], dividend = dec, remainder = 0;
  while (dividend >= 2) {
    remainder = dividend % 2;
    bits.push(remainder);
    dividend = (dividend - remainder) / 2;
  }
  bits.push(dividend);
  bits.reverse();
  return bits.join("");
}

// 利用二進位特性的非遞歸快速幂
function exp(x, m) {
  var y = 1;
  var bin = toBin(m).split('');
  for (var j = 0; j < bin.length; j++) {
    y = y * 2;
    if (bin[j] == "1") y = x * y;
  }
  return y;
}
八、多項式求值:Horner 法
給定實數係數 An, An-1, …, A1, A0 與實數 x,要求多項式 Pn(x) 的值。
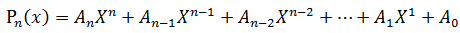
Horner 公式把多項式改寫成嵌套形式:
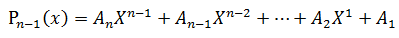
於是:
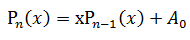
只需 N 次乘法加 N 次加法:
function horner(A, x) {
  var n = A.length - 1;
  var p = A[n];
  for (var j = 0; j < n; j++) p = x * p + A[n - j - 1];
  return p;
}
// 計算 y(2) = 3x^3 + 2x^2 + x - 1
alert(horner([-1, 1, 2, 3], 2));   // 33
九、多數問題(Boyer-Moore 投票法)
在長度為 n 的陣列中找出出現次數超過 n/2 的元素,常用於快速判定得票是否過半:
// 找出「可能存在」的多數元素
function candidate(A, m) {
  var count = 1, c = A[m], n = A.length - 1;
  while (m < n && count > 0) {
    m++;
    if (A[m] == c) count++; else count--;
  }
  return (m == n) ? c : candidate(A, m + 1);
}

// 尋找多數元素,O(n)
function majority(A) {
  var c = candidate(A, 0);
  var count = 0;
  for (var i = 0; i < A.length; i++) if (A[i] == c) count++;
  // 候選者未必真的是多數元素,必須再驗證一次
  return (count > Math.floor(A.length / 2)) ? c : null;
}
alert(majority([3, 2, 3, 3, 4, 3]));
其依據的結論是:從原序列移除兩個相異元素後,原本的多數元素在新序列中仍然是多數元素。證明不難——若原序列長度 n、多數元素出現 x 次且 x/n > 1/2:若移除的兩元素都不含多數元素,比例變為 x/(n-2),顯然仍大於 1/2;若含有一個多數元素,比例為 (x-1)/(n-2),而 x > n/2,代入得 (x-1)/(n-2) > (n/2-1)/(n-2) = 1/2。
十、全排列
function swap(A, i, j) { var t = A[i]; A[i] = A[j]; A[j] = t; }
function println(msg) { document.write(msg + "<br/>"); }

function perm(P, m) {
  var n = P.length - 1;
  if (m == n) { println(P); return; }   // 完成一個新排列
  for (var j = m; j <= n; j++) {
    swap(P, j, m);        // 起始元素與後面每個元素交換
    perm(P, m + 1);       // 在前 m 個已排好的基礎上繼續
    swap(P, j, m);        // 換回來,還原呼叫前的現場,避免產生重複排列
  }
}
perm([1, 2, 3], 0);
// 1,2,3 / 1,3,2 / 2,1,3 / 2,3,1 / 3,2,1 / 3,1,2
十一、分治法
分治的關鍵在於切分子問題時盡量讓兩半規模相當,才能真正發揮「以對數級縮小問題規模」的優勢。
// 尋找陣列中的最大值與最小值(分治法)
function findMinMaxDiv(A, low, high) {
  if (high - low == 1) {          // 最小規模子問題
    return (A[low] < A[high]) ? [A[low], A[high]] : [A[high], A[low]];
  }
  var mid = Math.floor((low + high) / 2);
  var r1 = findMinMaxDiv(A, low, mid);      // 前半部
  var r2 = findMinMaxDiv(A, mid + 1, high); // 後半部
  var x = r1[0] > r2[0] ? r2[0] : r1[0];
  var y = r1[1] > r2[1] ? r1[1] : r2[1];
  return [x, y];
}
println(findMinMaxDiv([1,2,3,4,5,6,7,8], 0, 7));   // 1,8

// 二分搜尋(分治法)
function binarySearchDiv(A, x, low, high) {
  if (low > high) return -1;
  var mid = Math.floor((low + high) / 2);
  if (x == A[mid]) return mid;
  else if (x < A[mid]) return binarySearchDiv(A, x, low, mid - 1);
  else                 return binarySearchDiv(A, x, mid + 1, high);
}
println(binarySearchDiv([1,2,3,4,5,6,7], 4, 0, 6));   // 3

// 以 low 位置元素為界,把陣列劃分為前後兩半
function split(A, low, n) {
  if (n >= A.length - 1) n = A.length - 1;
  var i = low, x = A[low];
  for (var j = low + 1; j <= n; j++) {
    if (A[j] <= x) { i++; if (i != j) swap(A, i, j); }
  }
  swap(A, low, i);      // 把分界元素放到分水嶺位置
  return [A, i];
}
var A = [5, 1, 2, 6, 3];
println(split(A, 0, A.length - 1)[0]);   // 3,1,2,5,6

// 快速排序
function quickSort(A, low, high) {
  if (low < high) {
    var w = split(A, low, high)[1];
    quickSort(A, low, w - 1);
    quickSort(A, w + 1, high);
  }
}
var A = [5, 6, 4, 7, 3];
quickSort(A, 0, A.length - 1);
println(A);   // 3,4,5,6,7
split 的思路也能拿來解其他問題。例如把整數陣列重排,讓所有負數集中到非負數左側,要求 O(n):
function sort1(A) {
  var i = 0, j = A.length - 1;
  while (i < j) {
    if (A[i] >= 0 && A[j] >= 0)      j--;
    else if (A[i] < 0 && A[j] < 0)   i++;
    else if (A[i] > 0 && A[j] < 0) { swap(A, i, j); i++; j--; }
    else                             { i++; j--; }
  }
}

function sort2(A) {
  if (A.length <= 1) return;
  var i = 0;
  for (var j = i + 1; j < A.length; j++) {
    if (A[j] < 0 && A[i] >= 0) { swap(A, i, j); i++; }
  }
}

var a = [1, -2, 3, -4, 5, -6, 0]; sort1(a); println(a);
var b = [1, -2, 3, -4, 5, -6, 0]; sort2(b); println(b);
這些演算法彼此並不獨立:分治是快速排序與二分搜尋的共同骨架,堆排序建立在 siftUp/siftDown 之上,而遞歸則是描述它們最自然的語言。把每個範例實際跑一遍、觀察中間狀態,比背誦複雜度更能建立真正的理解。
- 上一篇文章: JavaScript 資料結構實作:二叉搜尋樹完整範例
- 下一篇文章: 用原生 JavaScript 打造浪漫上升氣泡動畫
相關文章
-
JavaScript 與 HTML5 Canvas 打造猜牌小遊戲 快速排序原理深入解析與 Java 實作 JavaScript 堆排序(Heap Sort)原理與實作詳解 JavaScript 排序演算法:合併排序(歸並排序)實戰兩例 JavaScript 堆排序(Heap Sort)原理與實作全解 堆排序 Heap Sort 原理圖解與 JavaScript 實現 用 JavaScript 實作二分搜尋:在有序陣列中快速定位元素 快速排序在 PHP 與 JavaScript 中的實作差異 用 JS 找出「完全對稱日」:以 20111102 為例 HTML5 Canvas 猜牌小遊戲:三次點擊找出你心裡的牌