堆排序 combines 二叉堆的結構特性與「就地排序」的空間優勢,時間複雜度穩定,是理解樹形資料結構的一條優良路徑。要講清楚它,得先從二叉樹說起。
一、二叉樹基礎
在電腦科學中,二叉樹是每個節點最多擁有兩棵子樹的樹結構,這兩棵子樹通常稱為「左子樹」與「右子樹」。二叉樹常用來實作二叉查找樹與二叉堆。
二叉樹的每個節點至多有兩棵子樹(不存在度大於 2 的節點),且左右次序不可顛倒。第 i 層至多有 2i-1 個節點;深度為 k 的二叉樹至多有 2k-1 個節點;若終端節點數為 n0、度為 2 的節點數為 n2,則恆有 n0 = n2 + 1。
樹與二叉樹的三個主要差異:
- 樹的節點數至少為 1,二叉樹的節點數可以為 0。
- 樹中節點的最大度數沒有上限,二叉樹節點的最大度數為 2。
- 樹的節點無左右之分,二叉樹的節點有左右之分。
二叉樹又可細分為滿二叉樹與完全二叉樹。
滿二叉樹:深度為 k 且有 2k-1 個節點的二叉樹。
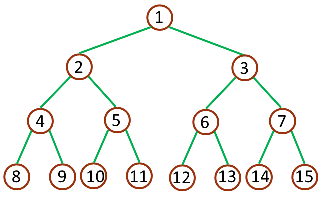
(深度為 3 的滿二叉樹 full binary tree)
完全二叉樹:深度為 k、有 n 個節點的二叉樹,當且僅當每個節點都與深度為 k 的滿二叉樹中序號 1 至 n 的節點一一對應。
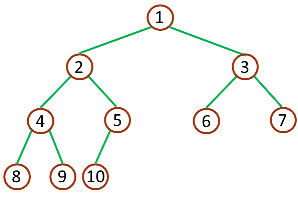
(深度為 3 的完全二叉樹 complete binary tree)
二、堆是什麼
二叉堆可以視為一棵完全二叉樹。完全二叉樹「除最底層外每層皆滿」的特性,讓堆得以直接用陣列表示——每一個節點對應陣列中的一個元素,而不必像一般二叉樹那樣使用鏈表。
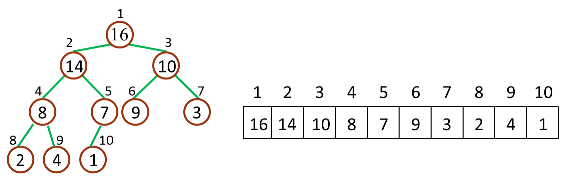
(堆和陣列的相互關係)
給定某節點的下標 i,其父節點與孩子節點的下標可直接算出:
Parent(i) = floor(i/2)   // i 的父節點下標
Left(i)   = 2i           // i 的左子節點下標
Right(i)  = 2i + 1       // i 的右子節點下標
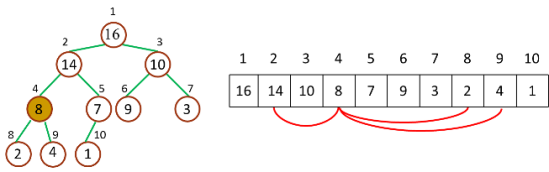
二叉堆一般分為最大堆與最小堆兩種。
最大堆:最大值出現在根節點(堆頂);每個父節點的值都大於等於其孩子節點(若存在)。
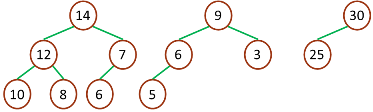
(最大堆)
最小堆:最小值出現在根節點;每個父節點的值都小於等於其孩子節點(若存在)。
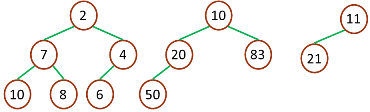
(最小堆)
三、堆排序的原理
堆排序的思路很樸素:把最大堆的堆頂取出,將剩餘元素重新調整為最大堆,再取出新的堆頂,如此反覆,直到只剩一個元素。實作上通常把取出的堆頂與陣列末尾交換,从而「就地」完成排序。
三個核心操作:
- 最大堆調整(Max-Heapify):調整末端子節點,確保子節點永不超過父節點。
- 建立最大堆(Build-Max-Heap):把任意陣列重排成最大堆。
- 堆排序(Heap-Sort):取出根節點並反覆執行最大堆調整。
實作前必須注意:JavaScript 陣列是 Zero-Based 的,堆的模型與下標公式都要相應調整。
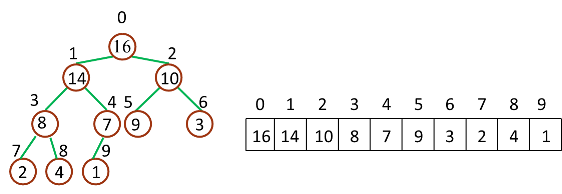
(Zero-Based 情形)
Parent(i) = floor((i-1)/2)   // i 的父節點下標
Left(i)   = 2i + 1           // i 的左子節點下標
Right(i)  = 2(i + 1)         // i 的右子節點下標
最大堆調整 Max-Heapify
Max-Heapify 的作用是維持最大堆的性質,也是建立最大堆的核心子程序:
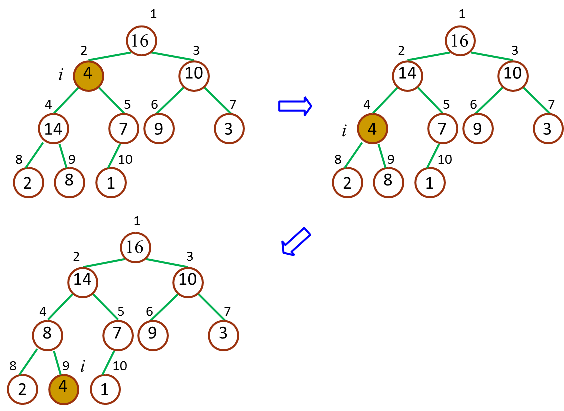
(Max-Heapify)
一次調整後堆仍可能違反性質,因此需要遞歸測試,讓整個堆都滿足堆性質:
/**
 * 從 index 開始檢查並保持最大堆性質
 *
 * @array
 * @index    檢查的起始下標
 * @heapSize 堆大小
 **/
function maxHeapify(array, index, heapSize) {
  var iMax = index,
      iLeft = 2 * index + 1,
      iRight = 2 * (index + 1);

  if (iLeft < heapSize && array[index] < array[iLeft]) {
    iMax = iLeft;
  }
  if (iRight < heapSize && array[iMax] < array[iRight]) {
    iMax = iRight;
  }
  if (iMax != index) {
    swap(array, iMax, index);
    maxHeapify(array, iMax, heapSize);   // 遞歸調整
  }
}

function swap(array, i, j) {
  var temp = array[i];
  array[i] = array[j];
  array[j] = temp;
}
遞歸主要見於分治法,這裡並不需要分治。而且遞歸呼叫需要壓棧/清棧,效能上比迭代略遜一籌——依照 20/80 法則這點差距可以忽略,但若你在意,也可以改寫成迭代版本:
function maxHeapify(array, index, heapSize) {
  var iMax, iLeft, iRight;
  while (true) {
    iMax = index;
    iLeft = 2 * index + 1;
    iRight = 2 * (index + 1);

    if (iLeft < heapSize && array[index] < array[iLeft]) {
      iMax = iLeft;
    }
    if (iRight < heapSize && array[iMax] < array[iRight]) {
      iMax = iRight;
    }
    if (iMax != index) {
      swap(array, iMax, index);
      index = iMax;
    } else {
      break;
    }
  }
}

function swap(array, i, j) {
  var temp = array[i];
  array[i] = array[j];
  array[j] = temp;
}
建立最大堆 Build-Max-Heap
Build-Max-Heap 負責把任意陣列改造成最大堆,接受陣列與堆大小兩個參數,並由下而上呼叫 Max-Heapify。由於 Max-Heapify 能保證下標 i 之後的節點皆滿足最大堆性質,自下而上的呼叫順序恰好能在改造過程中維持這一不變式。若元素數量為 n,則從 Parent(n) 開始,往上依次調整。

function buildMaxHeap(array, heapSize) {
  var i, iParent = Math.floor((heapSize - 1) / 2);
  for (i = iParent; i >= 0; i--) {
    maxHeapify(array, i, heapSize);
  }
}
堆排序 Heap-Sort
Heap-Sort 是對外的介面演算法:先呼叫 Build-Max-Heap 建立最大堆,接著把堆頂與堆底交換、堆的有效範圍上移一格,再重新呼叫 Max-Heapify 維持性質。由於堆頂必然是當前最大值,一次操作就分離出一個最大元素,重複 n-1 次後陣列即完成排序。

function heapSort(array, heapSize) {
  buildMaxHeap(array, heapSize);
  for (var i = heapSize - 1; i > 0; i--) {
    swap(array, 0, i);
    maxHeapify(array, 0, i);
  }
}
四、完整的 JavaScript 實作
function heapSort(array) {

  function swap(array, i, j) {
    var temp = array[i];
    array[i] = array[j];
    array[j] = temp;
  }

  function maxHeapify(array, index, heapSize) {
    var iMax, iLeft, iRight;
    while (true) {
      iMax = index;
      iLeft = 2 * index + 1;
      iRight = 2 * (index + 1);

      if (iLeft < heapSize && array[index] < array[iLeft]) {
        iMax = iLeft;
      }
      if (iRight < heapSize && array[iMax] < array[iRight]) {
        iMax = iRight;
      }
      if (iMax != index) {
        swap(array, iMax, index);
        index = iMax;
      } else {
        break;
      }
    }
  }

  function buildMaxHeap(array) {
    var i, iParent = Math.floor(array.length / 2) - 1;
    for (i = iParent; i >= 0; i--) {
      maxHeapify(array, i, array.length);
    }
  }

  function sort(array) {
    buildMaxHeap(array);
    for (var i = array.length - 1; i > 0; i--) {
      swap(array, 0, i);
      maxHeapify(array, 0, i);
    }
    return array;
  }

  return sort(array);
}
五、堆排序的實用評估
效能與複雜度
堆排序的時間複雜度非常穩定,對輸入資料的分布不敏感,最好與最壞情況都是 O(n log n)。空間複雜度則依實作而異,常見有 O(n) 與 O(1) 兩種;基於節省空間的考量,推薦採用 O(1) 的原地版本。
穩定性
堆排序存在大量篩選與長距離搬移,屬於不穩定的排序演算法。
適用場景
建立堆與調整堆的過程開銷較大,資料量很小時並不划算。但在資料量龐大時,它是相當可靠的選擇;尤其面對「前 n 大的數」這類問題,堆幾乎是首選方案——只需維護一個大小為 n 的堆,即可在單次遍歷中得出結果。
- 上一篇文章: Backbone.js 模型 Model 與集合 Collection 詳解
- 下一篇文章: JavaScript 學習必備的七個實踐要點