以 Python 實作 kNN:從原理到豆瓣電影性別預測
編輯:JavaScript基礎知識
kNN,也就是 K 最近鄰演算法,是機器學習中相當直觀的分類方法。它的核心概念是:若一個樣本在特徵空間中最接近的 k 個鄰居大多屬於某一類別,則該樣本也被歸類為該類別。

在上圖中,綠色圓點需要被分類。若 k 值為 3,周圍較多的是紅色三角形,因此會被歸為紅色類別;若 k 值為 5,藍色方形佔比較高,則可能被歸為藍色類別。這個例子說明了 k 值會直接影響分類結果。
實驗設計
本文以豆瓣電影資料為例,假設不同性別的使用者對電影類型偏好有所差異。研究选取 274 位使用者最近看過的 100 部電影,統計 37 種電影類型作為特徵,並以性別作為標籤建立樣本集。
資料格式可簡化為:每列代表一位使用者,前 37 個欄位是電影類型數量,最後一個欄位是性別標籤,0 表示男性,1 表示女性。
實驗中取 10% 作為測試樣本,其餘作為訓練樣本。為了避免不同特徵因數值範圍差異而影響距離計算,會先對資料進行正規化。
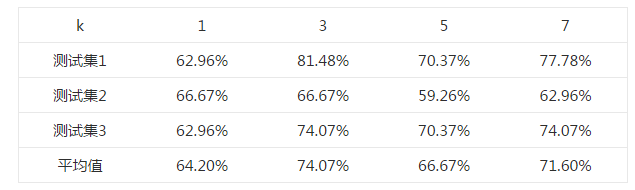
在 k 值選擇上,可嘗試 1、3、5、7 等不同值。結果顯示,在該資料集中 k 值為 3 時平均正確率較高,最高可達到約 81.48%。
核心 Python 代碼
以下為 kNN 分類的核心概念,重點在於計算歐氏距離、排序,並取出前 k 個鄰居的標籤進行投票。
from numpy import tile
import operator

def classify0(inX, dataSet, labels, k):
    dataSetSize = dataSet.shape[0]
    diffMat = tile(inX, (dataSetSize, 1)) - dataSet
    sqDiffMat = diffMat ** 2
    sqDistances = sqDiffMat.sum(axis=1)
    distances = sqDistances ** 0.5
    sortedDistIndicies = distances.argsort()

    classCount = {}
    for i in range(k):
        voteIlabel = labels[sortedDistIndicies[i]]
        classCount[voteIlabel] = classCount.get(voteIlabel, 0) + 1

    sortedClassCount = sorted(
        classCount.items(),
        key=operator.itemgetter(1),
        reverse=True
    )
    return sortedClassCount[0][0]
kNN 不只可以用於分類,也可以用於回歸。若要走回歸路線,可以取最近鄰屬性的平均值,或依距離給予不同權重,例如距離越近權重越高。
- 上一篇文章: JavaScript 瀏覽器定位:window.location 與 history 實用指南
- 下一篇文章: Windows 上使用 PyCharm 與 Visual Studio 建立 Python 開發環境
相關文章
-
Python 字符串處理:靈活就是它最大的優點 XML、Python,在 ASP 中究竟有什麼優勢? XML 與 Python 在 ASP 專案裡,到底有什麼優勢? Python smtplib 模組寄送電子郵件完整教學 Node.js 與 PHP、Python 的字元處理效能對比 用 Node.js 與 Python 打造簡易 HTTP 靜態檔案伺服器 在 Node.js 中調用系統命令、Shell 腳本與 Python 腳本的方法與實例 用開源程式搭一個個人線上音樂站:edna 與 Python 入門 用 Python 抓取 Ajax 動態資料:以淘寶評論為例 Python 腳本在後台運行的幾種方式